もっち
大手SIerに18年勤務。オンプレ・クラウド計200台規模の大規模インフラ(10システム)を統括する現役のサービスマネージャーです。
もっち
大手SIerに18年勤務。オンプレ・クラウド計200台規模の大規模インフラ(10システム)を統括する現役のサービスマネージャーです。
▼▼▼まずはここからチェック!
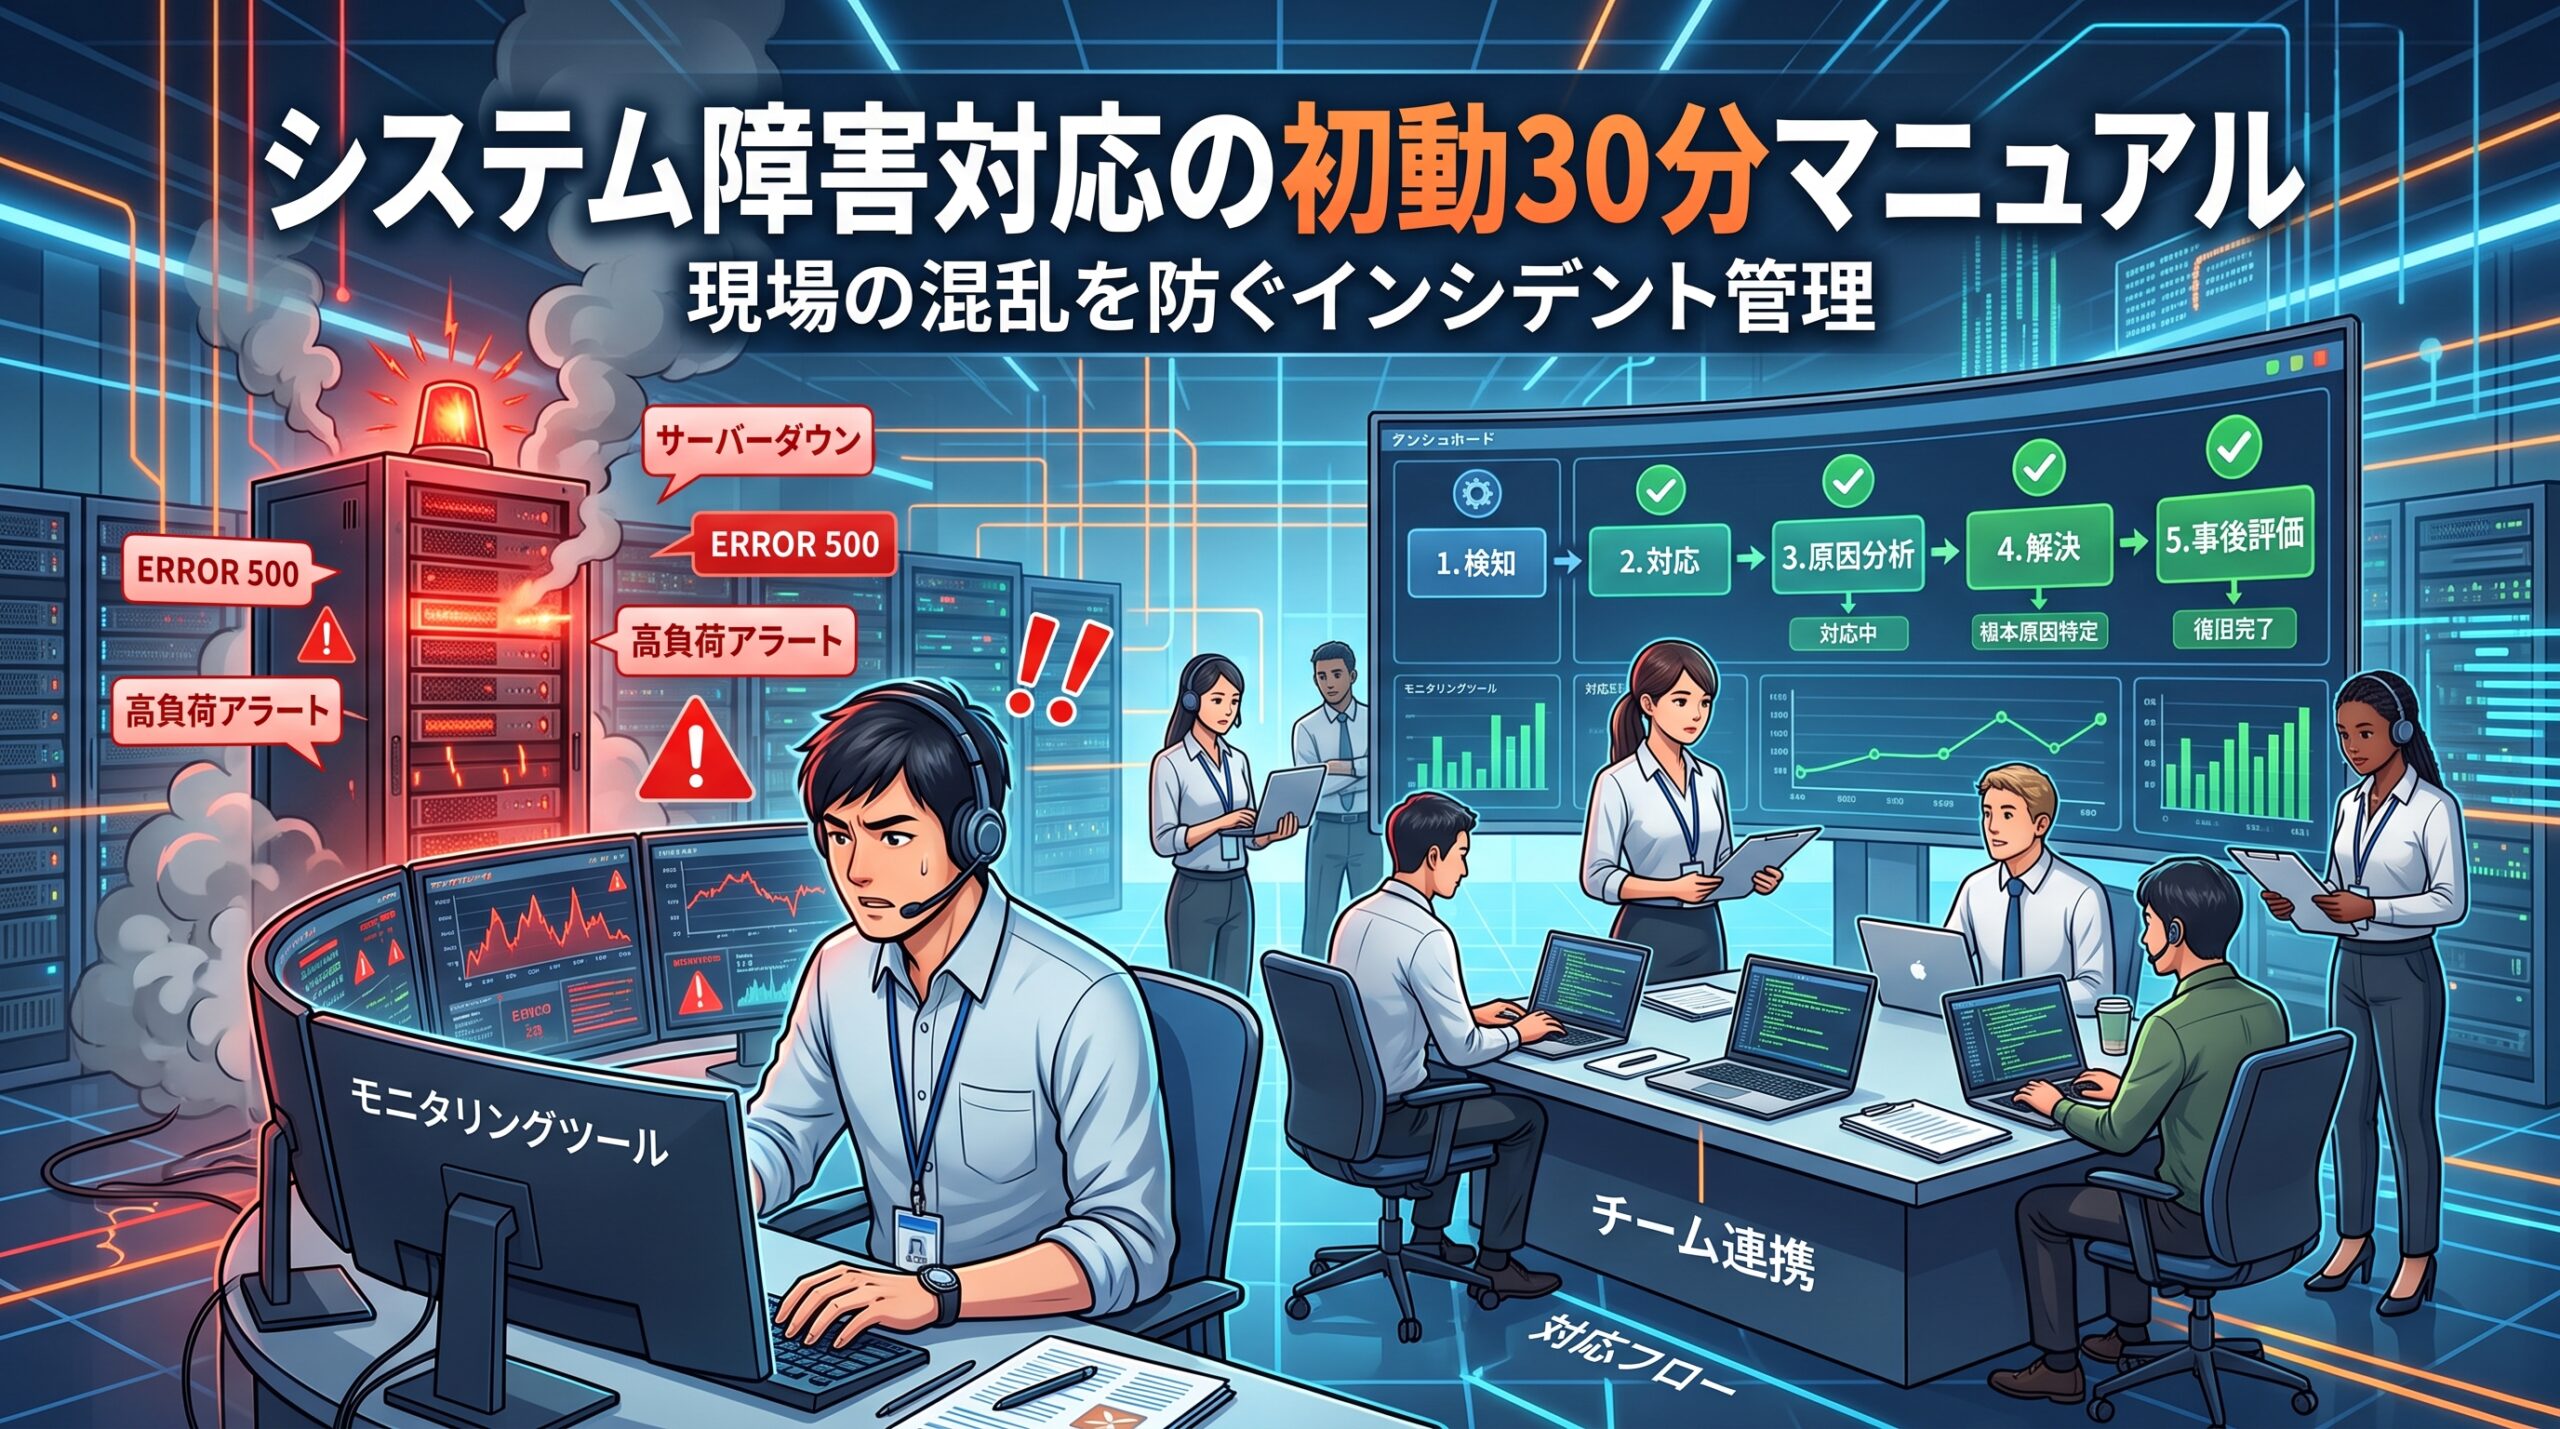
深夜や休日のオンコール、あるいはアクセスが集中する日中のコアタイム。突然鳴り響くアラート通知とともに、ビジネスサイドやカスタマーサポートからチャットへ矢のような催促が飛んできます。
「〇〇サービスが落ちています!」
「管理画面にアクセスできないと問い合わせが殺到しています。復旧の目処は!?」
こうした緊迫した現場において、被害の拡大を防ぎ最短でサービスを復旧へ導く鍵は、個人のハッカースキルではなく「初動30分の立ち回りの型」にあります。
この記事では、ITILの原則をベースに、混乱を抑えて最短でサービスを復旧へ導くための「初動30分の立ち回り」と「システム障害時の立ち回り方法」について実践的なマニュアルとして解説します。
この記事の想定読者
この記事を読むことでのメリット
トラブル発生直後、現場が混乱して二次被害を招いてしまうケースには共通したパターンが存在します。まずは避けるべき3つの初動ミスを整理します。
アラート検知直後にログ解析やスタックトレースの追跡へ全員が飛びついてしまう状態です。技術者として「なぜ起きたのか」を突き止めたくなるのは自然ですが、ビジネス側がまず把握しなければならないのは「何が起きているか(対象機能、顧客への影響範囲、サービス停止の規模)」です。
影響度(重大度)の正確な把握を怠ると、エスカレーションの遅れや優先度判定の誤りにつながります。
「原因や復旧見込みが正確に判明するまで、外へ報告できない」と現場が情報を抱え込んでしまう現象です。技術チームが沈黙を保つと、経営層や関係部門は「事態を認識しているのかすら分からない」状態に置かれます。
その結果、「状況はどうなっていますか?」という催促の連絡が殺到し、調査中のエンジニアの集中力を奪う悪循環が生まれます。
手が空いているメンバー全員が各自の判断でサーバーにログインし、個別に調査や再起動を試みてしまうケースです。
全体を指揮する司令塔がいないため、作業の重複や確認漏れが発生し、最悪の場合は誤ったオペレーションによる二次障害(設定ファイルの上書きや不要なクラスタ切り離しなど)を誘発します。
混乱を抑え、チームの足並みを揃えるための指針となるのが、ITサービスマネジメントの標準体系であるITIL(Information Technology Infrastructure Library)の考え方です。
ITILでは、「インシデント管理」と「問題管理」を明確に区別しています。
【障害発生中:インシデント管理フェーズ】
  ・最優先:サービスを動かすこと(暫定復旧・ワークアラウンド)
  ・後回し:根本原因の特定、再発防止策の策定
        │
        ▼ サービス復旧完了
【復旧後:問題管理フェーズ】
  ・根本原因の調査、コード修正、インフラ設計の見直し、ポストモーテム
障害対応中、多くのエンジニアが「いま再起動したりトラフィックを迂回させたりすると、揮発性メモリのログが消えて原因が追えなくなるのではないか」というジレンマに直面します。
しかし、ビジネスの観点から最優先されるべきは「原因の究明」ではなく「サービスが正常に稼働している状態を取り戻すこと」です。
直前のシステムログやスタックダンプの最小限の退避(あるいは仮想マシンのスナップショット取得)を行ったら、迷わずワークアラウンドの適用へと舵を切る判断が求められます。
インシデントコマンダー(IC:Incident Commander)とは、障害対応における全権を持ち、状況判断・意思決定・内外のコミュニケーション統制を一手に担う最高指揮官のことです。
重大インシデントにおいては、技術作業を行う「オペレーター」と、全体を統制する「IC」の役割を明確に分ける体制が不可欠です。
[ステークホルダー(経営陣 / CS / 営業)]
                     ▲
                     │ 報告・窓口の一元化
                     ▼
       【インシデントコマンダー (IC)】 ── (タイムライン記録) ──▶ 【スクライブ】
         ・状況判断と優先度決定
         ・タイムキーピング(判断期限の設定)
         ・コマンドは打たない
                     ▲
                     │ 作業指示・状況報告
                     ▼
          【オペレーター(作業担当)】
         ・調査・切り分けに専念
         ・ワークアラウンドの実行
指揮と作業を分けることで、作業者は「報告プレッシャー」から解放されて技術作業のミスを防ぐことができ、ICは鳥瞰的な視野で冷静な経営的・技術的判断を下せるようになります。
大規模障害を検知してから最初の30分間、チームが迷わず稼働するための標準フローです。
[00〜05分] 検知・重大度判定・IC体制の確立
    │
[05〜15分] 状況把握(Fact収集) & 第一報送信
    │
[15〜25分] 直近変更の確認 & ワークアラウンド(復旧方針)決定
    │
[25〜30分] 方針実行指示 & 第二報(進捗報告)送信
【コピペで使える「第一報」テンプレート】
Plaintext
件名: 【障害第1報】〇〇サービスにおける一部アクセス障害について

関係者各位

〇〇サービスにて障害を検知しましたので、第1報を報告いたします。

■ 発生事象:〇〇機能において画面表示エラー(HTTP 500)が断続的に発生
■ 影響範囲:〇〇サービスを利用中の全ユーザー
■ 現在のステータス:インシデント対策体制を立ち上げ、影響範囲の特定およびログ調査を実施中
■ 直近の対応方針:直近リリースの切り戻し可否、および影響サーバー群の再起動を検討中
■ 次回報告予定:〇〇:〇〇(※15〜30分後を目安に指定)
ワークアラウンドによってサービスが復旧した時点で、インシデント管理は完了します。しかし、ここで対応を終了させてはいけません。再発を防ぐための「問題管理」フェーズへ確実にバトンを渡す必要があります。
対応中にスクライブ(記録係)が残した記録をもとに、「何時何分にアラート鳴動」「何時何分に第一報発信」「何時何分にロールバック実施」といった客観的な時系列データを整理します。数日経つと個人の記憶は急速に曖昧になるため、当日のうちにタイムラインを固定することが肝要です。
振り返りを行う際、最も重視すべきは「個人の責任追及をしない」文化です。
人を責める空気が存在すると、次回から現場はミスの隠蔽に走り、初動のエスカレーションが致命的に遅れるようになります。見直すべきは常に「仕組み・監視・プロセス」です。
Q. 2〜3人の少人数チームでもインシデントコマンダー(IC)は立てるべきですか?
A. 立てるべきです。
人数が少ないチームほど、全員が技術調査に入って外部連絡が完全に止まるリスクが高くなります。2名体制であれば「1名がIC兼連絡・記録係、もう1名が調査・作業専任」と明確に役割を切り分けることで、現場の混乱と連絡ミスを確実に防ぐことができます。
Q. ログを保全する前に再起動して根本原因が追えなくなった場合、後から社内で問題になりませんか?
A. 事前の合意形成が重要です。
平時から「インシデント管理の最優先事項は事業損失を防ぐ暫定復旧であり、根本原因の特定よりも優先される」という原則を、開発チームだけでなくビジネスサイドや経営陣と合意(SLA/SLOの定義や運用ポリシーとして明文化)しておくことが不可欠です。
Q. 第一報の段階で復旧目処が全く分からないときはどう書けばいいですか?
A. 「復旧見込みは現時点で未定」と正直に記載し、「次回報告時刻」を必ず指定します。
関係者が最も不安を感じるのは情報が途絶えることです。「原因調査中であり復旧時刻は未定だが、状況の進捗を30分後の〇時〇分に再度報告する」と約束するだけで、催促の連絡を大幅に抑えることができます。
システム障害の発生を100%防ぐことは不可能です。緊迫した状況下で現場を救うのは、個人のひらめきではなく、チーム全員が規律を持って動くための「初動の型」です。
すべてを一度に整備する必要はありません。まずは平時のうちに「障害時のICは誰が担うか」「第一報のフォーマットはどこに置くか」をチームで合意しておくことから始めてみてください。
その小さな共通認識が、次にアラートが鳴ったときの被害を最小限に抑える確かな防波堤になるはずです。
▼▼▼まずはここからチェック!