もっち
大手SIerに18年勤務。オンプレ・クラウド計200台規模の大規模インフラ(10システム)を統括する現役のサービスマネージャーです。

もっち
大手SIerに18年勤務。オンプレ・クラウド計200台規模の大規模インフラ(10システム)を統括する現役のサービスマネージャーです。
▼▼▼まずはここからチェック!
インフラエンジニアとして実務に入ると、基本設計書や構成図で必ず目にするのが「クラスター(クラスタ)」や「冗長化構成」という言葉です。
こうした疑問を抱えたまま現場のレビューや障害訓練に臨むと、構成の意図が読み解けず、大きな不安を感じてしまうものです。
クラスタ技術は、システムの信頼性を担保するインフラ設計の骨格です。
この記事では、クラスタ技術の全体像(HA・負荷分散・HPC)を整理した上で、現場で最も設計力が問われる「HAクラスター」の2つの動作モード(Active-Standby / Active-Active)と、Active-Activeの2大実装パターン(負荷分散型 vs 相互待機型)を分かりやすく解説します。
さらに、教科書には載っていない「片肺運転時のサイジングの罠」や「現場で自動フェイルバックを禁止する理由」といった現場運用のリアルな勘所まで網羅しました。
この記事を読めば、設計書に書かれたパラメータの狙いが手に取るように理解でき、トラブルシューティングや設計レビューに自信を持って臨めるようになります。
【10秒でわかる】クラスタ動作モードのクイック比較
- Active-Standby(片系待機型):1台稼働・1台待機。データの不整合が起きず最も安全。ただし待機機のコストが発生する。
- Active-Active(負荷分散型):全台稼働。Webサーバーなどのステートレス(データを持たない)環境に最適。
- Active-Active(相互待機型):別業務を並行稼働。リソース効率は高いが、片肺運転時のサイジング(平時CPU 50%以下)が必須。
※どの構成を選ぶべきかの判断手順は、記事後半の選定ステップで詳しく解説しています。
この記事の想定読者
この記事を読むことでのメリット
クラスター技術とは、複数台のサーバーをネットワークで結合し、外部からは全体で1台の巨大なシステムであるかのように振る舞わせる技術です。
なぜコストと構成の複雑さを増やしてまで、複数台のサーバーを束ねるのか。目的は大きく分けて「止まらないこと(可用性の向上)」と「速くさばくこと(処理性能の拡張)」の2点に集約されます。
この目的の違いによって、クラスタ技術は大きく3種類に大別されます。

| クラスター種別 | 主な目的 | システム要件 | 代表的な適用箇所 | 実現する主要技術 |
| HAクラスター (High Availability) | 可用性の向上 (耐障害・業務継続) | 稼働率99.99%以上の維持 迅速な自動復旧 | 基幹データベース ファイルサーバー | クラスタ制御ソフト 共有ストレージ、VIP |
| 負荷分散クラスター (Load Balancing) | 処理性能の向上 (スケーラビリティ) | 大量アクセスの均等分散 柔軟なスケールアウト | Webサーバー APIサーバー | ロードバランサー(L4/L7) リバースプロキシ |
| HPCクラスター (High Performance Computing) | 演算処理の高速化 (並列計算) | 膨大な数値計算の短時間処理 | 科学技術計算 気象予測、AIモデル学習 | 並列処理ライブラリ(MPI) 超高速インターコネクト |
システムの「稼働率」を高め、24時間365日止めないことを目指す構成です。
現場で単に「クラスタ構成」や「冗長化」と言う場合、大半はこのHAクラスターを指します。1台のサーバーにハードウェア故障やOSクラッシュが発生しても、待機している別のサーバーが自動で業務を引き継ぎ、ダウンタイムを最小限に抑えます。
大量のトラフィック(アクセス)を複数台のサーバーに均等に割り振る構成です。
システムの入り口に「ロードバランサー(負荷分散装置)」を配置し、背後に並べたWebサーバー群へリクエストを分散させます。アクセス数が増加した際に、サーバーの台数を増やすことでシステム全体の処理能力を強化する「スケールアウト」が容易な点が特徴です。
いわゆる「スーパーコンピューター」の領域です。
多数の計算用サーバー(ノード)を専用の超高速ネットワークで繋ぎ、1つの巨大で複雑なタスクを細かく分割して並列実行させます。
インフラエンジニアの実務において、設計・運用の両面で最も深く関わり、設計力が問われるのが「HAクラスター」です。ここからは、HAクラスターの具体的な仕組みに焦点を絞って解説を進めます。
HAクラスターの設計で最初に決めるべきは、サーバーをどう待機させるかという「動作モード」です。
アプローチは大きく2つに分かれます。
それぞれの仕組み、メリット・デメリット、そして選定基準を詳しく見ていきましょう。
Active-Standbyは、1台を「本番用」、もう1台を「障害時の予備用」として構える最も確実な冗長化構成です。
1台のサーバーを「Active(現用系・主系・本番機)」として稼働させて全リクエストを処理し、もう1台の「Standby(待機系・副系・予備機)」をバックアップ専用として待機させます。通常時、クライアントからのリクエストはすべてActiveサーバーだけで処理します。

「待機」と一言で言っても、スタンバイサーバーをどのような状態で待たせておくかによって、「ホットスタンバイ」「ウォームスタンバイ」「コールドスタンバイ」3つの方式に分類することができます。
設計書作成や見積もりで必須となる3つのレベルを、データの同期状態、復旧時間(RTO:目標復旧時間)と維持コストの視点を加えて整理しました。
| 比較項目 | ホットスタンバイ(Hot Standby) | ウォームスタンバイ(Warm Standby) | コールドスタンバイ(Cold Standby) |
| 待機側の状態 | OS・ミドルウェア・アプリが常時起動 | OSは起動、アプリは停止または参照専用 | 電源OFF、または別用途(検証等)で稼働 |
| データの同期状態 | リアルタイム同期(遅延ほぼゼロ) | 準リアルタイム(定期ログ転送や差分同期) | 非同期(定期バックアップデータのみ) |
| 目標復旧時間(RTO) | 数秒 〜 数十秒(自動切り替え) | 数分 〜 数十分(手動またはスクリプト) | 数時間 〜 数日(物理作業・リストア) |
| コスト | 高(本番同等の待機機+クラスタソフト) | 中〜高(常時稼働分のインフラ費用) | 低(予備機のハード代のみ、または共用) |
| 主なユースケース | 止まることが許されない基幹DB、EC決済 | 準基幹システム、参照専用(Read)活用環境 | 停止が許容される社内情報系、DR環境 |
Active-Standbyを採用するとき、現場の設計レビューで必ず突っ込まれるのが「障害時に待機系へどうやって最新データを引き継ぐのか?」というストレージ設計です。
2台から1つのストレージを見る「共有ディスク型」にするか、サーバー同士でデータを同期する「データミラー型」にするかで、構築コストや耐障害性は大きく変わります。
クラウド環境での適性も含めて比較したい方は、ぜひ以下の記事を参考にしてください。

Active-Active構成は全サーバーが同時に稼働してリソースをフル活用する構成であり、Standbyのように遊んでいるサーバーが存在しないため、インフラの投資対効果(コスパ)を最大化できます。

ただし、実務におけるActive-Activeには仕組みも用途もまったく異なる「2つの実装パターン」があります。ここを混同して会話すると現場で必ず齟齬が生まれるため、明確に区別しておきましょう。
フロントエンドにロードバランサーを配置し、後ろに並べた複数のサーバーへ均等にリクエストを振り分ける構成です。
基幹システムやデータベースなど、サーバーが更新データを保持する「ステートフル」な環境で、リソースを無駄にしないために採用される構成です。
サーバーAとサーバーBが、それぞれ別々の業務のActiveを務めながら、同時に互いの待機系(Standby)を兼任します。
相互待機型は無駄のない合理的な構成に見えますが、サイジング(性能見積もり)を誤ると現場で最悪の障害を引き起こします。
1台がダウンした縮退運転時、残されたサーバーには2倍の負荷が集中します。
【現場で実際にあった失敗談】
平時のCPU使用率が60%前後で稼働していた相互待機型のシステムで、夜間に片系のサーバーがハード障害でダウンしました。
残ったもう片方のサーバーに全トラフィックが雪崩れ込んだ結果、瞬時にCPU使用率が100%に張り付き、メモリ枯渇によるOOM Killerが多発。結果として残った正常なサーバーまでクラッシュし、深夜に2つの基幹業務が同時に全停止する二重障害に至りました。
相互待機型を設計する際は、「片肺運転時でもシステム全体の業務が破綻しないか」を厳密に計算し、平常時のリソース使用率上限を40〜50%以下に抑えるキャパシティ設計が絶対条件となります。
実務で検討される主要な3つのHAクラスタパターンを一覧表で比較しました。設計レビューや要件定義の判断材料として活用してください。
| 比較項目 | Active-Standby(ホットスタンバイ) | Active-Active(負荷分散型) | Active-Active(相互待機型) |
| 主な用途 | データベース、基幹システム | Webサーバー、APIサーバー | 複数業務を相乗りさせるDB/AP |
| フェイルオーバー時間 | 数秒 〜 数十秒 | 実質ゼロ(LBによる切り離し) | 数秒 〜 数十秒 |
| 平時のリソース効率 | ✕(待機機がアイドル状態) | ◎(全ノードをフル活用) | ◯(別業務で全ノードを活用) |
| 障害時の性能影響 | 変化なし(100%の処理能力維持) | 性能低下(台数減による処理能力低下) | 著しい性能低下のリスクあり |
| 設計・構築の難易度 | 標準的 | 比較的容易(疎結合) | 極めて高い(リソース競合・排他制御) |
| コスト構造 | 待機機分のハード・ライセンスが必要 | スケールに応じた柔軟な投資が可能 | 高(設計検証工数、ソフトライセンス) |
HAクラスタの運用において最も重要なのは、障害発生時の切り替えではなく「復旧後の切り戻しルール」です。
現場のサービスマネージャーや運用リーダーが最も気をつけている運用のポイントを紹介します。
障害発生時にActiveからStandbyへ業務を切り替える処理を「フェイルオーバー」と呼びますが、逆に障害機が修理・復旧した際に元の系へ業務を戻す処理を「フェイルバック(切り戻し)」と呼びます。
市販のクラスタソフトには「障害機が復帰したら自動で元の状態へ戻す(自動フェイルバック)」機能が用意されていることが多いですが、エンタープライズの現場では基本的にこの機能を無効化(手動切り戻し)します。
仮に自動フェイルバックを有効にしていると、壊れかけのハードウェアが原因で「フラッピング(切り替えの無限ループ)」が発生するためです。
短時間に業務停止と切り替えが繰り返されると、データベースの不整合やトランザクションの破壊を招き、目も当てられない事態になります。
【運用の鉄則】
フェイルオーバーは業務継続のために自動で素早く行う。ただし、フェイルバック(切り戻し)は原因究明とハードウェア交換を完全に終えた後、利用者の少ない夜間や休日に計画停止を設けて手動で行う。これが運用設計のセオリーです。
HAクラスタ運用において、インフラエンジニアが最も恐れる致命的な障害が「スプリットブレイン(Split-Brain)」です。
2台のサーバーを結ぶ監視用の通信線(ハートビート線)が断線すると、Standby側は「相手の信号が途絶えた=Active側が死んだ」と判断して、自身をActiveへ昇格させようとします。しかし、元のActive側も正常に動き続けています。
その結果、「1つのシステムの中に2台のActive(主系)が同時に存在し、両者がストレージの同じデータ領域に異なる内容を書き込んでデータを完全に破壊する」という大惨事に発展します。
現場では、このスプリットブレインを絶対に防ぐために「クォーラム(多数決判定)」や「フェンシング(相手ノードの電源を物理的に強制遮断する仕組み)」といった防衛機構を必ず組み込みます。
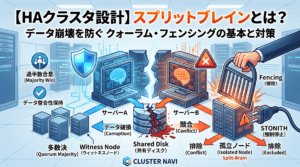
死活監視が切れた際、クラスタはどちらを本物と判定するのか?
両ノードが暴走してデータを壊し合う「スプリットブレイン」の発生メカニズムと、それを防ぐQuorum(多数決判定)やSTONITH(フェンシング)の仕組みについては、以下の記事でシーケンス図を交えて徹底解説しています。
クラウドの普及によって構成手順は変わりましたが、冗長化の設計思想そのものは今も変わっていません。
「AWSやAzureを使えば、もうActive-Standbyのような泥臭い設計は不要になるのでは?」と考える方もいるかもしれません。しかし、実際はインフラエンジニアが手動で組んでいた仕組みが、クラウド事業者のマネージドサービスとして抽象化・自動化されただけです。
マネージドサービスの裏側で何が起きているのかを正しく見抜き、障害発生時に「ネットワーク・ディスク・プロセスのどこで問題が起きているのか」を切り分けるためにも、クラスタの基礎原理を理解しておくことが不可欠です。
クラスタ構成の選定は、最新技術を追うことではなく「業務要件(RTO/RPO)と予算のバランスを最適化すること」です。
実務で構成に迷った際は、以下の3ステップで検討を進めてください。
クラスタの動作モードを理解したら、次は「データの持ち方(ストレージ)」と「異常時の防衛策」の2つを押さえることで、実務の設計書を完全に読み解けるようになります。
現場で活躍できるプロフェッショナルを目指す方は、ぜひ以下のステップで学びを深めてみてください。
まずは自社で運用しているシステム構成図を開き、稼働しているサーバー群が「どのクラスタ型に該当し、どんなパラメータで設計されているか」を照らし合わせることから始めてみてください。
▼▼▼まずはここからチェック!