もっち
大手SIerに18年勤務。オンプレ・クラウド計200台規模の大規模インフラ(10システム)を統括する現役のサービスマネージャーです。
もっち
大手SIerに18年勤務。オンプレ・クラウド計200台規模の大規模インフラ(10システム)を統括する現役のサービスマネージャーです。
▼▼▼まずはここからチェック!
インフラエンジニアとしてキャリアを積むと、必ず直面する「数字の矛盾」があります。
「CPU使用率は低いのに、アプリケーションの応答が極端に遅い」
「ロードアベレージは異常に高いが、サーバー自体は負荷が低そうに見える」
これらの現象を「OSの機嫌が悪い」で片付けてはいけません。そこには必ず、OSのスケジューラ、スレッド管理、そしてハードウェア特性に裏打ちされた「論理(ロジック)」が存在します。
本記事では、インフラエンジニアが単なる「数字を眺める人」から「システム内部を透視できるプロ」へステップアップするために、CPU使用率とロードアベレージの決定的な違い、危険水準の目安、そしてトラブルシューティングの手順を図解付きで分かりやすく解説します。
この記事の想定読者
この記事を読むことでのメリット
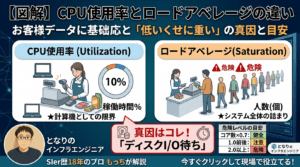
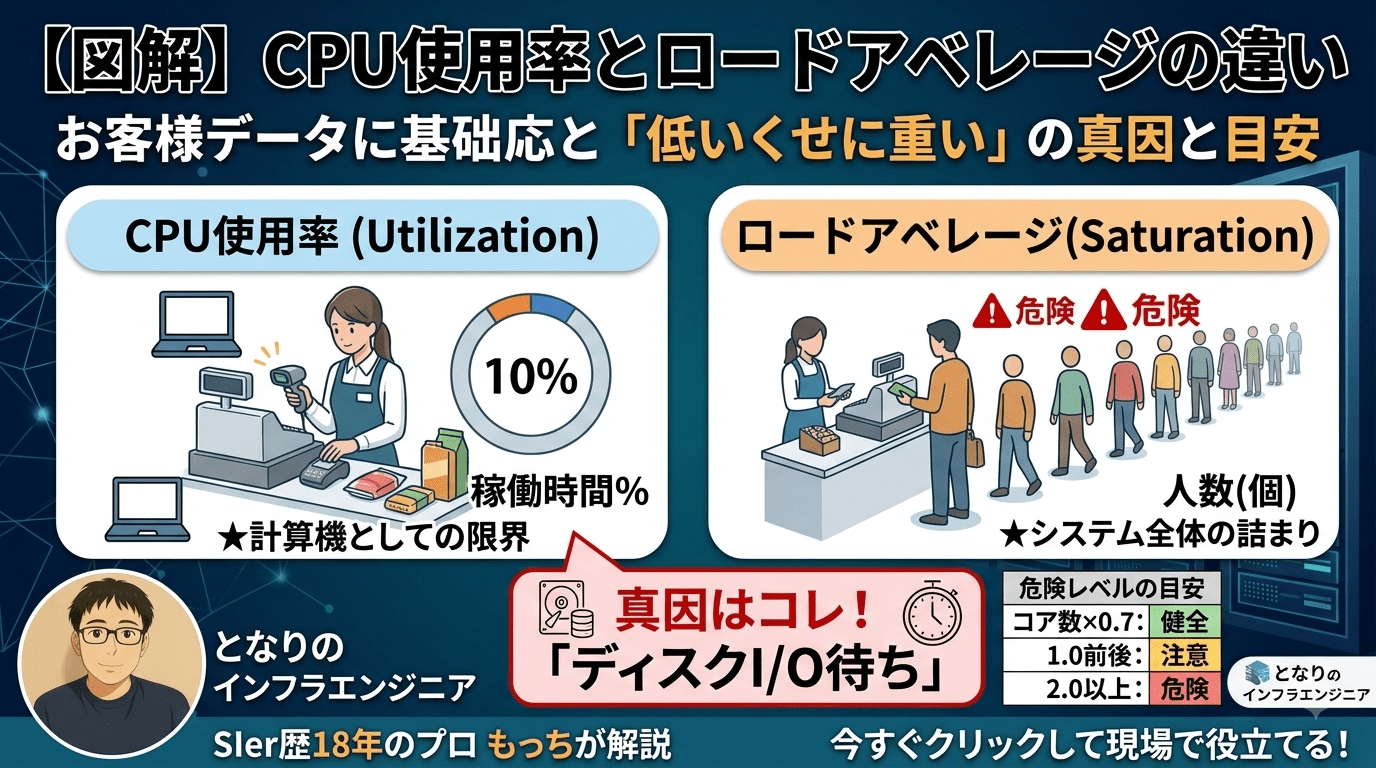
一言で言えば、CPU使用率は「計算機が働いていた時間の割合(%)」、ロードアベレージは「処理を待っている行列の長さ(個数)」です。
さらにLinuxでは「ディスクI/O待ち」もロードアベレージに含まれるため、「CPU使用率は低いのにシステムが重い」という現象が発生します。
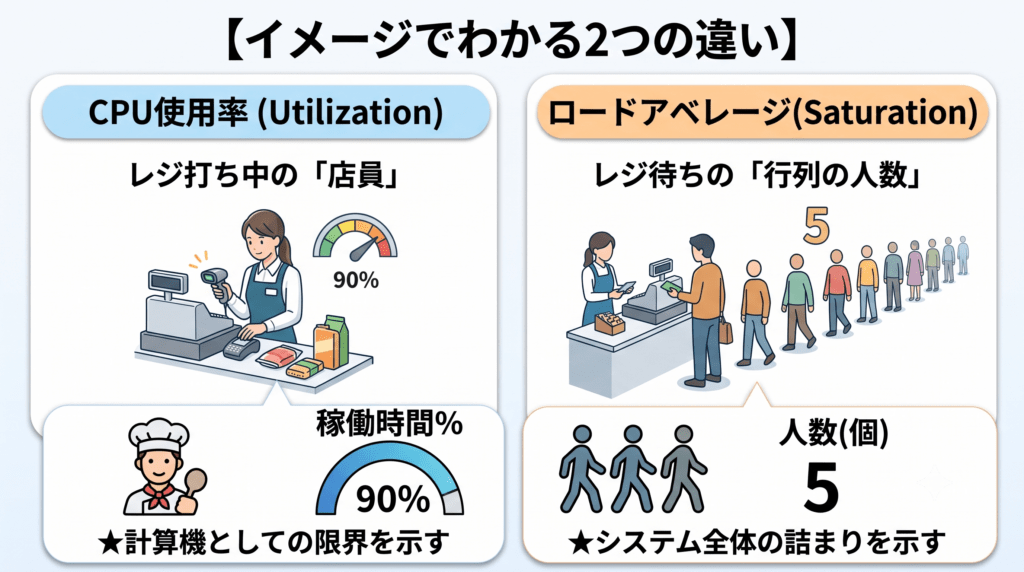
CPU使用率は、一言で言えば「CPUがどれだけ休まず働いていたかの割合(%)」です。
対して、Linux等で重視されるロードアベレージは「割合(%)」ではなく「プロセス数(個数)」で表されます。
WindowsとLinuxでは「負荷」の定義に決定的な違いがあります。
| OS | 主な指標 | 含まれるもの | 特徴 |
| Linux | ロードアベレージ | CPU実行中 + CPU待ち + ディスクI/O待ち | ストレージが遅いだけでも数値が跳ね上がる |
| Windows | CPU使用率 | CPU実行中のみ | ディスク遅延は「ディスク使用率」として別管理 |
つまり、Linuxにおいて「CPU使用率は10%なのに、ロードアベレージが10を超えている」という現象が起きたら、それはCPUの計算能力不足ではなく、「HDD/SSDの読み書き待ちで、処理が大渋滞している(D状態プロセス)」ことを意味します。
CPUやメモリ、OSの基本構造をまずは難解な数式抜きでイメージから掴みたい方には『絵で見てわかるOS/ストレージ/ネットワーク 新装版』がおすすめです。
アーキテクチャの基礎が図解で丁寧に整理されているため、若手エンジニアが基礎体力をつける最初の一冊としてこれ以上ないほど親しみやすい良書です。
「ロードアベレージが『5』を超えたら危険ですか?」という質問をよく受けますが、答えは「CPUのコア数による」です。
1コアのサーバーにおける「ロードアベレージ 5」は大渋滞ですが、16コアのサーバーにおける「5」はスカスカの健全な状態です。ロードアベレージは必ず「論理CPUコア数との比較」で判断してください。
| 状態レベル | 1コアあたりの数値 | システムの状況 | 現場エンジニアが取るべきアクション |
| 🟢 健全(正常) | 0.7 未満 | 処理に十分な余裕がある状態。 | 静観でOK。定期モニタリングを継続。 |
| 🟡 注意(混雑開始) | 1.0 前後 | CPUリソースをちょうど使い切っている状態。 | 処理の遅延が始まっていないか確認。 |
| 🔴 危険(ボトルネック) | 2.0 以上 | 待ち行列が発生し、明確な遅延が発生。 | 緊急調査が必要。I/O待ちかCPU枯渇かを特定。 |
💡 1分・5分・15分値の見方
uptimeやtopコマンドで表示される「1分前 / 5分前 / 15分前」の3つの数値の「変化の傾向」を見ます。
2.0,1.5,0.5(数値が上昇傾向):現在進行形で負荷が急速に高まっている(緊急対応要)0.5,1.5,2.0(数値が低下傾向):スパイク的な負荷が過ぎ去り、沈静化に向かっている
現場で最も混乱しやすい「CPU使用率は低いのにレスポンスが極端に遅い」というトラブル。18年の経験上、原因は以下の3パターンに集約されます。
先述の通り、Linuxのロードアベレージには「ストレージの読み書き待ち(Uninterruptible Sleep / D状態)」が含まれます。
データベースのフルスキャンや大量のログ書き込みが発生すると、CPUは「データの到着待ち」で手が止まるためCPU使用率は低くなりますが、待たされているプロセスで行列ができるためロードアベレージは激増します。
なお、ディスクI/O待ちが激増する最大の原因のひとつが「メモリ不足によるSWAP(スワップ)」です。メモリ枯渇がなぜストレージ遅延を引き起こすのか、そのメカニズムと正しい監視手法は以下の記事で詳しく解説しています。
top 実行中に 1 キー押下)で見ると「1つのコア(CPU0)だけが100%」に張り付き、残り7コアは暇を囲っている状態です。シングルスレッド限界に直面した場合、単純なコア追加では解決しません。トラブルを未然に防ぐ「適切なCPU数やスペックの割り出し方」や、経営層を納得させるサイジング計算式については以下の記事で解説しています。
多数のWebリクエストや小規模プロセスが一斉に立ち上がると、OSはミリ秒単位で処理するプロセスを切り替えます(コンテキストスイッチ)。
切り替え処理自体にCPUパワーが食われ、本来行うべきアプリの処理が進まなくなる「交通整理パニック」状態です。vmstat コマンドで cs(Context Switch)の数値が異常に高い場合はこれを疑います。
「CPU使用率やロードアベレージの数値の裏で、Linuxがどう動いているのか」を視覚的に理解するなら、『[試して理解する]Linuxのしくみ』が一番の近道です。
プロセスがどうCPUを奪い合い、なぜ待ち行列(ロードアベレージ)が発生するのかが豊富な図解と実験で分かります。コマンドの結果を脳内でビジュアル化できるようになりたい若手エンジニア必読の1冊です。
オンプレミス環境と異なり、AWSやDocker等のモダン環境では「OSのメトリクスが正常に見えても裏で制限されている」ケースがあります。
AWS EC2などの仮想環境で top を実行した際、%st(Steal Time)の数値を確認してください。
DockerやKubernetes環境では、CPU使用率が50%程度でもレスポンスがミリ秒単位で遅延することがあります。
パフォーマンス分析の世界的権威であるブレンダン・グレッグ(Brendan Gregg)氏が提唱する「USEメソッド」をCPU監視に適用することで、勘に頼らない論理的な調査が可能になります。
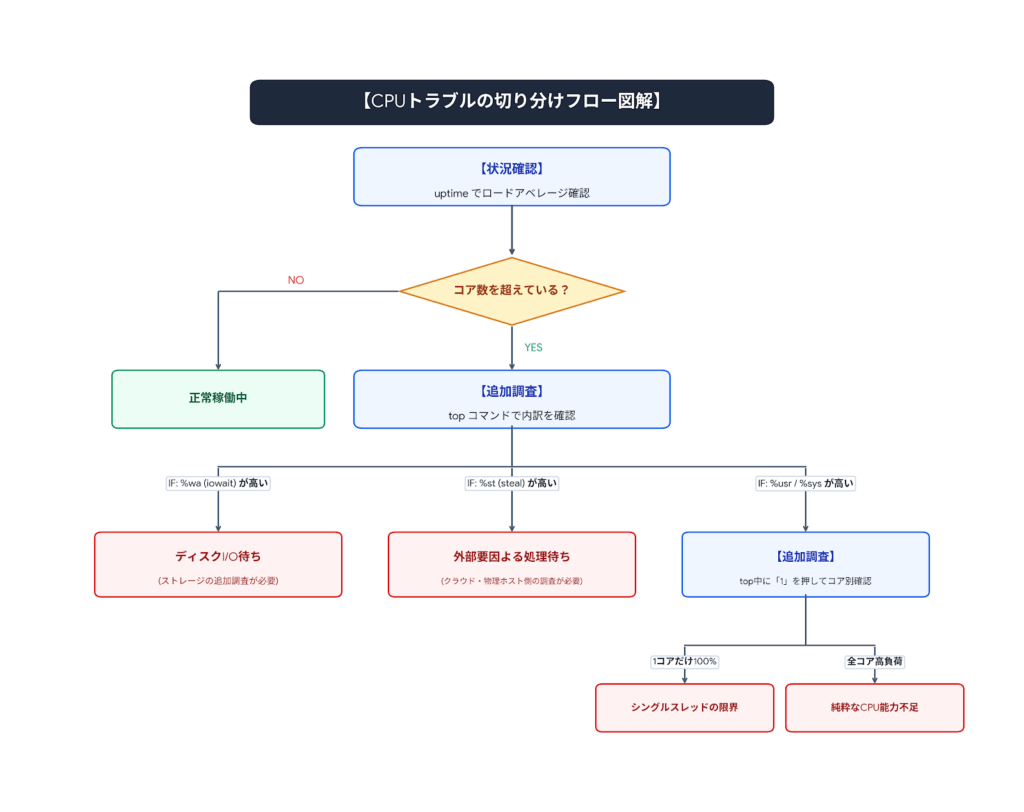
uptime でロードアベレージを確認(【状況確認】)➔ コア数を超えているか?(超えていなければ正常稼働中。超えていれば混雑が発生中)top で内訳を確認(【追加調査】)
%wa(iowait)が高い ➔ ディスクI/O待ち(ストレージの追加調査が必要)%st(steal)が高い ➔ 外部要因による処理待ち(クラウド・物理ホスト側の調査が必要)%usr / %sys が高い ➔ アプリ・OSの計算負荷が高い(ステップ3へ)top 実行中に 1 キーを押し、コアごとの偏りを確認(【詳細調査】)
今回紹介した「USEメソッド」の提唱者であるブレンダン・グレッグ氏の世界的名著が、この『詳解 システム・パフォーマンス 第2版』です。
CPUやロードアベレージの数値の裏で、OSやハードウェアがどう動いているのかが徹底的に網羅されています。このメソッドの本質を学び、システム全体のボトルネックを迷わず特定できる一生物のスキルを身につけたいなら、間違いなく究極の一冊です。
CPUのパフォーマンス分析とは、単に top コマンドの一番上に出る「CPU使用率」の数字を報告することではありません。
18年のインフラ運用経験から断言できるのは、「標準ツールの出力を正しく組み合わせて見れば、原因を特定できないパフォーマンス問題はほとんど存在しない」ということです。
ぜひ今日から、表面的な「平均値」という言葉を疑い、数字の裏にあるOSの論理を解明してみてください。
 現役サービスマネージャーが解説する「プロセス管理」の真髄|大規模システムを支えるOSの基礎知識
メモリ使用率80%で慌てない!歴18年のプロが教える「SWAP・ページング」の本質と現場の監視術(Linux/Windows対応)
▼▼▼まずはここからチェック!