もっち
大手SIerに18年勤務。オンプレ・クラウド計200台規模の大規模インフラ(10システム)を統括する現役のサービスマネージャーです。
もっち
大手SIerに18年勤務。オンプレ・クラウド計200台規模の大規模インフラ(10システム)を統括する現役のサービスマネージャーです。
▼▼▼まずはここからチェック!
「新しく構築するWebサーバー、CPUは何コアにする?」「メモリは64GBで足りる?それとも128GB積むべき?」
設計構築やリプレイス案件を担当した際、先輩や顧客から「なぜそのスペックにしたの?」と根拠を問われ、言葉に詰まってしまった経験はありませんか?
「なんとなく多めに積んでおけば安心」というサイジングは、オンプレミスならコスト超過で却下され、クラウドなら毎月の予算承認の壁に突き当たります。
今回は、18年間にわたり数々の修羅場を潜り抜けてきた筆者が、現場で実際に使っている「CPU・メモリ・ストレージ・RAID・NIC」の具体的な計算式、代入例、スペック目安一覧を余すところなく解説します。
この記事の想定読者
この記事を読むことでのメリット
忙しい現場エンジニアのために、実務で標準的に使われるサイジングの判断基準を一覧表にまとめました。まずはこの数値をベースに検討をスタートしてください。
| リソース | 設計の目標値・目安 | 主な選定理由・根拠 |
| CPU | ピーク時使用率 60%〜70% | 監視閾値(80%)に引っかからない安全圏。スパイク耐性を確保。 |
| メモリ | 必要積算量 + 30%以上のバッファ | 枯渇すると即OS停止に直結。OS/ミドル更新余力とキャッシュ効果。 |
| ストレージ容量 | (将来予測容量)× 1.2〜1.3倍 | ログ急増、DBインデックス再構築、パッチ適用時の一時領域を確保。 |
| ストレージ種別 | 性能重視:SSD 容量・コスト重視:HDD | DBや仮想化ホストはSSD一択。長期ログ保管やバックアップは安価なHDD。 |
| RAID構成 | OS領域:RAID 1 データ領域:RAID 10 または 5/6 | OSは可用性重視のミラーリング。データはI/O速度と対障害性のバランス。 |
| NIC(回線) | ピーク帯域が上限の 60〜70%以下 | 通常通信だけでなく、夜間バックアップや大容量データ転送の帯域を考慮。 |
サイジングに取り掛かる際、最初に確認すべきは「既存システムの更改(リプレイス)」なのか「完全新規のシステム構築」なのかという点です。ここを混同すると作業が迷走します。
【既存システムの更改】
過去の実績データ(CPU・メモリ使用率)を収集 → ピーク値を基準に維持・見直し

【新規システムの構築】
要件ヒアリング(同時アクセス・データ量) → 計算式で仮設計 → 負荷テストで検証・修正
考え方は非常にシンプルです。過去のモニタリングデータ(月次運用レポートやZabbix/Datadog等のグラフ)を確認し、「通常時の平均」と「スパイク時のピーク値」をベースに判断します。
実績データがない新規案件では、後述する計算式を使って「仮のスペック」を設計します。
ただし、数字を決めて終わりにしてはいけません。可能であれば検証環境を構築し、Apache JMeterなどで疑似負荷テストを実施して実際のCPU・メモリ消費を測定するのがプロの鉄則です。
💡 クラウド時代の「ライトサイジング」と初期見積もりの関係
「AWSやAzureなら後からスケールできるから、事前のサイジングは適当でいいのでは?」と言われることがあります。
しかし、それは半分正解で半分間違いです。後から変更できるのはクラウドの強みですが、プロジェクト開始時の「初期予算承認(月額いくらかかるのか)」を通すための説明責任(アカウンタビリティ)として、事前の論理的サイジングは依然として必須のスキルです。
ここからは、設計書や見積根拠にそのまま書けるリソース別の計算式と、現場ならではの具体的な代入例を解説します。
CPUは「瞬間的なトランザクションをいかに遅延なく処理できるか」で決めます。
小数点以下を切り上げ、サーバーの規格に合わせて「10コア(または余裕を持って12〜16コア)」を選定します。
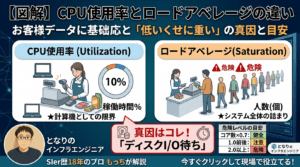
「CPU使用率は20%台なのに、なぜか処理が激重…」という現場トラブルに遭遇したことはありませんか?
その真因はシングルスレッド限界やディスクI/O待ちにあります。CPUの本当の負荷を見抜くための必須知識は以下の記事で図解しています。
メモリは「足りなくなったら即、システム停止(OOM Killer発動やクラッシュ)」を招くため、最も安全側に倒して見積もる必要があります。
計算結果が「36.4GB」になった場合、40GBや48GBでギリギリ設計するのは避けるべきです。
OSやミドルウェアの将来のバージョンアップで消費量が増加することや、空きメモリがOSのファイルキャッシュ(buff/cache)として機能しディスクI/Oを劇的に高速化することを考慮し、一段上の「64GB」を選定するのが現場のスタンダードです。
【私の失敗談:メモリ増設の代償】
かつてアプリの機能追加によるメモリ消費増を見落とし、本番稼働直後にメモリが枯渇。仮想基盤だったため緊急のオンライン増設でなんとか凌ぎましたが、深夜の緊急調整と顧客への障害報告書作成で、数日間生きた心地がしませんでした。
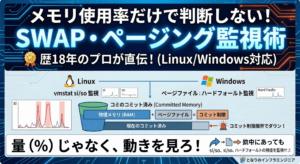
「メモリ使用率80%超え=危険」とは限りません。本当に危険なSWAP(ページング)の兆候と、現場で慌てないための監視術を徹底解説しています。
ストレージは「容量」だけでなく、「アクセス速度(I/O)」もセットで考えます。
【私の失敗談:DB表領域のパンク】
DBの「表領域(Tablespace)」の自動拡張設定を過信し、ファイルシステム側の残容量監視を甘くしていたため、深夜のバッチ処理中にディスクが100%になりDBが緊急停止したことがあります。ストレージサイジングは「一時領域」と「ログのローテーション設計」まで見通すことが肝要です。
ストレージ容量を計算したら、物理ディスクをどう束ねるか(RAID構成)を決めます。実務での選定基準は極めてシンプルです。
| RAID種別 | 特徴 | 実効容量 | 実務での採用方針 |
| RAID 1(ミラーリング) | 2台に同一書き込み。障害に強い | ディスク1本分 | OS・システム領域(容量は不要、可用性最優先) |
| RAID 10(1+0) | 高速・高信頼・高コスト | 構成台数の 1/2 | DB/APデータ領域(性能と対障害性を両立させる本番環境の王道) |
| RAID 5 / 6 | パリティ利用で容量効率が高い | 台数 – 1 (RAID 5) 台数 – 2 (RAID 6) | ファイルサーバー、ログ保管庫、バックアップ領域 |
実務では、1台のサーバーの中でも「OS領域はSSDのRAID 1」「DB/APデータ領域はSSDのRAID 10」というように、用途ごとにボリュームを分けて構成するのが定石です。
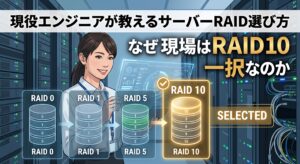
なぜエンタープライズの現場ではRAID 10が圧倒的に支持されるのか?
各RAIDの仕組みと実務での使い分け基準はこちらの記事で解説しています。
見落とされがちですが、インフラの可用性を担保する生命線がネットワークと電源です。
ここまでの計算式を統合し、実務でよくある「会員数10万人規模の社内業務システム(Web+DB分離構成)」を例にサイジングを組み立ててみましょう。
【サイジング試算結果と選定スペック】

■ Web/APサーバー(2台構成:ロードバランサー配下)
  ・CPU: 8コア / 16スレッド(1台障害時の片肺運転でも耐えられる余裕を確保)
  ・メモリ: 32GB(同時接続プロセス数 + OSファイルキャッシュ用)
  ・ストレージ: RAID 1(SSD 480GB × 2本 / OS・アクセスログ用)
  ・NIC: 1Gbps × 2ポート(チーミングによる冗長化)

■ DBサーバー(Active / Standby HAクラスタ構成)
  ・CPU: 16コア / 32スレッド(複雑な集計クエリや並行トランザクションに対応)
  ・メモリ: 64GB(InnoDBバッファプールを40GB以上確保しディスクI/Oを極小化)
  ・ストレージ(OS領域): RAID 1(SSD 480GB × 2本)
  ・ストレージ(DBデータ領域): RAID 10(SSD 960GB × 4本 / 実効容量 約1.9TB)
      ※ 計算根拠: 初期100GB + (50GB × 5年) = 350GB
      ※ 350GB × 安全マージン1.3 = 約455GB。RAID10(1.9TB)で将来のログ・一時領域も完全担保
  ・NIC: 10Gbps × 2ポート(データ同期レプリケーションおよび夜間バックアップ用)
サイジングは未来予測である以上、テレビ報道やSNSのバズなどによる「想定外のトラフィック」を100%防ぐことは不可能です。パンクした際の逃げ道もあらかじめ設計に盛り込んでおきましょう。
若手リーダーにぜひ身につけてほしいのが、サイジングを「自分一人の責任にしない」という戦略的な立ち回りです。
エンジニアが確認すべき情報は、過去のログだけでなく「ビジネスの未来」にあります。
正確な前提条件を顧客から引き出すためのヒアリング術は、以下の記事で解説しています。あわせて確認してみてください。
チャットや口頭のやり取りだけでスペックを決めてはいけません。
要件定義レビューや基本設計の定例会など、オフィシャルな会議の場で「事業計画に基づきこのスペックを選定した」と公式に説明し、合意エビデンスを議事録に残します。
万が一、数年後にリソースが逼迫した場合でも、エビデンスがあれば「エンジニアの設計ミス」ではなく「事業の急成長に伴う前向きなリサイズ投資」として、追加予算の稟議をスムーズに通すことができます。
算出したスペックは、詳細設計書のパラメータシートに『選定根拠』として落とし込みましょう。
「メモリ: 64GB」とだけ書くのではなく、「最大同時接続500セッション×プロセスサイズ+OSキャッシュ考慮」と添えるだけで、設計書レビューでの説得力が格段に跳ね上がります。
設計書のパラメータシートの作成方法は以下の記事で解説しています。あわせて確認してみてください。
サーバーサイジングとは、単に数字を当てはめる計算パズルではありません。
この3つの車輪が揃って初めて、経営層や顧客から「この人にインフラを任せれば安心だ」という絶対的な信頼を勝ち取ることができます。
本記事で紹介した計算式と目安表を武器に、ぜひ自信を持って次の設計レビューに挑んでみてください!
記事内で紹介したリソースの計算式を埋め込んだサーバサイジング自動計算シートをダウンロード専用ページで公開しています。
※ ページの閲覧に必要な認証キー(合言葉)は、公式X(@infra_mocchi)の固定ポストにて公開しています。ぜひチェックしてご活用ください!
サイジングは単なる計算作業ではありません。システムの信頼性を担保し、無駄なコストを抑えるという、インフラエンジニアとしての『誇り』に関わる仕事です。
こうした『守りの技術』をいかにして自分の価値(キャリア)に繋げていくか、私が18年の現場経験で感じたマインドセットについても、ぜひ一度読んでみてください。

▼▼▼まずはここからチェック!