もっち インフラエンジニア / ITサービスマネージャー
24時間365日の監視オペレーターからキャリアをスタート。設計・構築を経て、現在は8名チームのリーダーとしてミッションクリティカルな基盤運用を統括しています。
もっち インフラエンジニア / ITサービスマネージャー
24時間365日の監視オペレーターからキャリアをスタート。設計・構築を経て、現在は8名チームのリーダーとしてミッションクリティカルな基盤運用を統括しています。
Webシステムのインフラを支える上で、絶対に欠かせない存在であるロードバランサー(LB:負荷分散装置)。
基本情報技術者試験やAWS資格の勉強、あるいは実務の設計フェーズにおいて、必ずと言っていいほど直面するのが「L4とL7のロードバランサーって、結局何が違ってどう選べばいいの?」という疑問です。
さらに、現場の運用に入ると「教科書通りの知識」だけでは歯が立たない場面が多発します。
本記事では、L4ロードバランシングとL7ロードバランシングの根本的な違い・それぞれのメリットを体系的に整理し、クラウド(AWS等)やオンプレミスでの実践的な選定基準を解説します。さらに、パケットの詳細な変化や障害切り分けなど、「現場で泣かないためのリアルな運用知見」まで徹底的にまとめました。
この記事の想定読者
この記事を読むことでのメリット
ロードバランサーの最大の目的は、「負荷分散(スケーラビリティ)」と「高可用性(サバイバビリティ)」の実現です。
クライアント(ユーザー)からのアクセスを1箇所で受け止め、背後に控える複数のWebサーバーへバランスよく交通整理を行います。万が一、背後のサーバーが1台故障しても、正常なサーバーだけに通信を振り分けることで、サービス全体の停止を防ぎます。
ロードバランサーを理解する上で、ネットワーク的に最も重要な概念が「VIP」と「RIP」の2つのIPアドレスです。
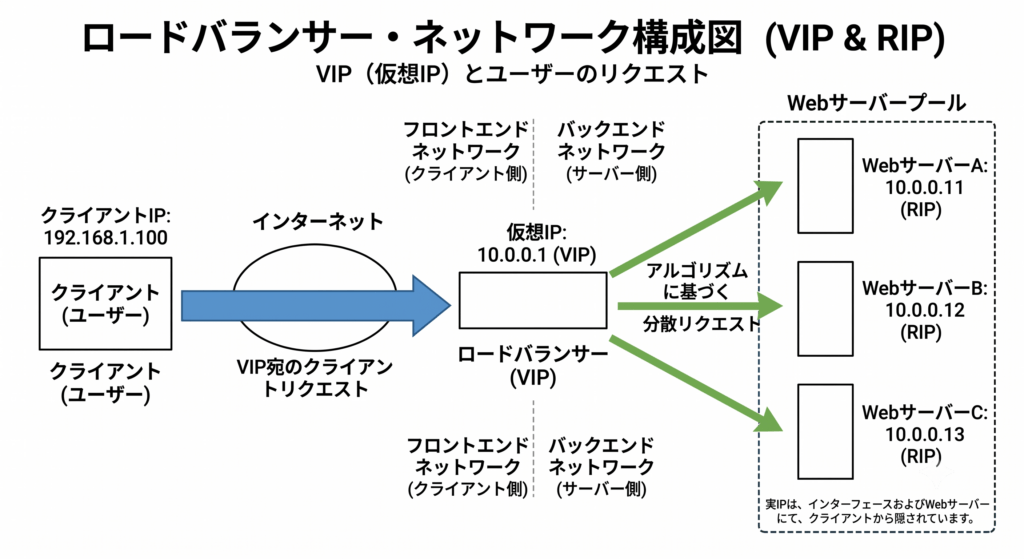
クライアントから見ると、Webサイトは「VIPを持つ1台の巨大なサーバー」に見えています。しかし裏側では、複数のRIPを持つサーバーたちがリクエストを分け合って処理しています。
ロードバランサーは、OSI参照モデルのどの階層(レイヤー)で通信を判別し、交通整理を行うかによって「L4(レイヤ4)」と「L7(レイヤ7)」に大別されます。
| 比較項目 | L4ロードバランサー | L7ロードバランサー |
| 動作レイヤー | トランスポート層(第4層) | アプリケーション層(第7層) |
| 主な判断基準 | 送信元/宛先IPアドレス、ポート番号 | URLパス、HTTPヘッダー、Cookie、データ内容 |
| 処理速度・スループット | 極めて高速(パケットの中身を見ない) | 高機能なぶんCPU負荷はやや高め |
| ルーティングの柔軟性 | シンプル(IP/ポート単位) | 極めて柔軟(URLパスやCookieで分岐可能) |
| セッション維持 | 送信元IPアドレス(ソースIPハッシュ等) | Cookie(スティッキーセッション等) |
| SSL/TLSの終端 | 基本的に透過(そのまま通す) | 可能(SSLオフロードでサーバー負荷を軽減) |
| 代表的なサービス・機器 | AWS NLB、L4スイッチ、IPVS | AWS ALB、Nginx、HAProxy、F5 BIG-IP |
レイヤ4(L4)ロードバランシングとは、TCPやUDPといったトランスポート層の情報(IPアドレスとポート番号)だけを見て振り分け先を決定する方式です。
パケットの内部(HTTPリクエストヘッダーやHTML本文など)は一切解析しません。「宛先IPが〇〇で、ポート番号が443(HTTPS)だから、サーバーAにそのまま流そう」という、極めてシンプルかつ機械的なルーティングを行います。
/api へのアクセスはAPIサーバーへ、/images は静的配信サーバーへ」といったURL単位の振り分けはできません。レイヤ7(L7)ロードバランシングは、アプリケーション層(HTTP/HTTPS)の通信内容までロードバランサーが踏み込んで解析し、高度な交通整理を行う仕組みです。
近年のWebシステムでL7ロードバランサーが標準的に採用されているのには、以下の5つの決定的なメリットがあるからです。
通信の中身(HTTPリクエスト)を読み取れるため、リクエスト内容に応じたスマートなルーティングが可能です。
[example.com/api/](https://example.com/api/)* はバックエンドのコンテナ群へ、[example.com/static/](https://example.com/static/)* はキャッシュサーバー群へ転送。admin.example.com と user.example.com を異なるサーバーへ振り分け。マイクロサービスアーキテクチャやコンテナ環境を運用する上で、この機能は必須となります。
Webサイトの全HTTPS化が当たり前となった現代において、暗号化・復号化(SSL/TLSハンドシェイク)にかかる計算負荷はサーバーのCPUを大きく圧迫します。
L7ロードバランサーにSSLサーバー証明書を配置すれば、暗号化通信をロードバランサー側で一度終わらせる(SSL終端 / SSLオフロード)ことができます。 ロードバランサーから背後のWebサーバー間はプレーンなHTTP(または軽量な暗号化)で通信できるため、Webサーバー側のCPUリソースを本来のアプリケーション処理に100%集中させることが可能です。また、証明書の更新作業もロードバランサー1箇所で完結します。
ECサイトのカート機能やログインセッションのように、「特定のユーザーからのアクセスは、常に同じサーバーに送り続けたい」ケースがあります。
L7ロードバランサーであれば、HTTPレスポンスに専用のCookieを付与し、次回以降のリクエストに含まれるCookieを読み取ることで、クライアントのIPアドレスが変わっても(例:スマホがWi-Fiから4G回線に切り替わっても)確実に同一サーバーへ通信を固定できます。
アプリケーション層のデータを検査できるため、ロードバランサーとWAF(Web Application Firewall)を直接連携させることが可能です。
インフラの最前線で「盾」として機能させることができます。
L4のヘルスチェック(PingやTCP接続確認)では、「Webサーバーのポート80は開いているが、裏でデータベースがダウンしていて500 Internal Server Errorを返している」という異常を見抜けません。
L7であれば、実際にHTTPリクエストを送信し、「HTTPステータスコード 200 OK が返ってくるか」「特定の文字列がレスポンス本文に含まれているか」まで確認できます。アプリケーションが真に健全に動作しているサーバーにだけ、安全にアクセスを振り分けることが可能です。
「自分のプロジェクトではL4とL7のどちらを採用すべきか?」 現場の要件定義で迷った際は、以下の具体例と判断基準を参考にしてください。
パブリッククラウド(AWS)における使い分けは、L4とL7の典型的な住み分けを示しています。
オンプレミスや物理データセンター環境でも、役割分担は同様です。
障害調査でパケットキャプチャ(tcpdumpなど)を叩いたとき、多くの若手エンジニアが「あれ?クライアントのIPが見当たらない」「どことどこが通信しているのかわからない」と混乱します。
なぜなら、ロードバランサー(L7リバースプロキシやFull NATなど)を経由する際、パケットに書き込まれている「送信元IP(Src)」と「宛先IP(Dst)」が途中で目まぐるしく書き換わるからです。
具体的な数値を例に、パケットの往復の流れを完全に可視化してみましょう。
192.168.1.100(Client-IP)10.0.0.1(外部向けの受付窓口)10.0.0.2(サーバーと通信する実体IP)10.0.0.11(実際に処理する裏方のサーバー)ユーザーがブラウザでWebサイトにアクセスした瞬間です。パケットはLBの「受付窓口(VIP)」を目指して飛んでいきます。
192.168.1.100(クライアント)10.0.0.1(LBのVIP)パケットを受け取ったLBは、振り分けアルゴリズムに従って「今回はWebサーバーAに処理を任せよう」と決めます。そして、パケットの送信元と宛先をどちらも書き換えてサーバーAに転送します。
10.0.0.2(LBの内部IPに変身!)10.0.0.11(WebサーバーAのRIPに変身!)💡 ここが実務のポイント!
WebサーバーAの視点に立つと、パケットの送信元(Src)はクライアントのIPではなく、「LBの内部IP(
10.0.0.2)」に見えています。そのため、Webサーバー側のアクセスログをそのまま見ると、すべてのアクセスがLBから来ているように見えてしまい、本当のクライアントIPが分かりません。(※これを防ぐため、LBはHTTPヘッダーに
X-Forwarded-For: 192.168.1.100のように元のクライアントIPを仕込んでサーバーに渡すのが一般的です)。
WebサーバーAが処理を終え、画面のデータを返します。サーバーAから見ると、頼んできた相手は「LB(10.0.0.2)」なので、LBに向けてパケットを返却します。
10.0.0.11(WebサーバーA)10.0.0.2(LBの内部IP)サーバーからデータを受け取ったLBは、「これはさっき192.168.1.100のクライアントから頼まれた分だな」と判断し、最後にパケットの仮面を元に戻してクライアントへ返します。
10.0.0.1(LBのVIPに戻る!)10.0.0.100(クライアントのIPに戻る!)一連の変化をタイムラインで表にまとめると、以下のようになります。
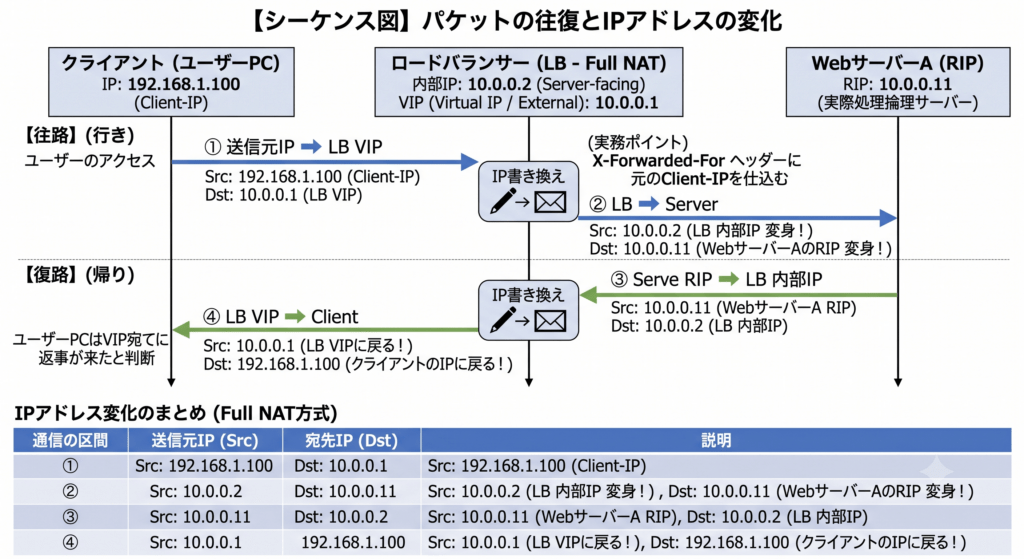
| 通信の区間 | 送信元IP (Source) | 宛先IP (Destination) | 説明 |
| ① クライアント→LB | 192.168.1.100 | 10.0.0.1 (VIP) | クライアントがVIP宛てに送信 |
| ② LB→Webサーバー | 10.0.0.2 (LB内部) | 10.0.0.11 (RIP) | LBが両方のIPを書き換えて転送 |
| ③ Webサーバー→LB | 10.0.0.11 (RIP) | 10.0.0.2 (LB内部) | サーバーがLB宛てに返信 |
| ④ LB→クライアント | 10.0.0.1 (VIP) | 192.168.1.100 | LBが元の仮面に戻してクライアントへ |
後述する「障害調査の難しさ」の理由はここにあります。通信が分散されるだけでなく、IPアドレス自体がLBの前後で「ガワ」を変えられてしまうため、このパラメータ変化を完璧に頭に入れておかなければ、パケットの迷宮に迷い込むことになります。
LBがどのように接続先を決めるのか、その「ルール」にあたるのが振り分けアルゴリズムです。そして、そのルールを補完するのがセッション維持(パーシスタンス)の仕組みです。
ECサイトでの買い物カゴや、ログイン状態の維持など、Webアプリケーションの多くは「一連の行動(セッション)」を特定のサーバーが覚え続ける必要があります。ラウンドロビンで毎回違うサーバーに飛ばされてしまうと、画面を遷移するたびにログアウトされてしまうといった問題が発生します。
これを防ぐために、CookieやソースIPアドレスを使って、一度紐付いたサーバーへ固定する仕組みが「セッション維持(スティッキーセッション)」です。
仕組み自体はシンプルに見えますが、実務においてはここが大きな落とし穴になります。
LBは、裏側のWebサーバーが正常に動いているかを常に監視し、壊れたサーバーがあれば自動的に切り離す機能を持っています。
主に L3(Ping)、L4(TCP)、L7(HTTP/HTTPS)のレベルで行われますが、ここで非常に重いトラブルとなるのが、「ヘルスチェックは通っているのに、アプリケーションは死んでいる」という状態です。
例えば、ヘルスチェックの対象をトップページ(index.html)といった静的ファイルにしていると、裏側でデータベース(DB)との接続が切れてエラー画面が出ている状態でも、LBは「Webサーバー自体は応答しているから正常!」と判断します。結果、エラーを吐き続けるサーバーにお客さんを誘導し続けてしまうのです。
ヘルスチェックを行う際は、内部の健全性を判定できる専用のパス(例:/health_check)を用意するのが鉄則です。
「ソースIP保持」によるセッション維持を選択している場合、社内プロキシや特定のゲートウェイを経由した大量のアクセスが、すべて同一のWebサーバー1台に偏ってしまう(負荷が集中する)という現象が起きることがあります。設計時には、ユーザーのアクセス経路の特性を考慮しなければなりません。
ここからが、実務で最もインフラエンジニアの頭を悩ませる「現場のリアル」です。
「一部のユーザーからだけ、たまにエラーが出ると問い合わせがあるが、社内でテストしても再現しない」
こうしたランダムに見える不具合の多くは、複数あるWebサーバーのうちの1台だけでバグや局所的なリソース枯渇が発生しているケースです。LBが通信を分散しているため、運悪くその不具合サーバーに当たった通信だけがエラーになります。
また、深夜のアプリケーションアップデートなどのメンテナンス後、LBのVIP宛てにブラウザからアクセスして「よし、画面が表示された!メンテ完了!」と判断するのは極めて危険です。その確認通信は「正常にアップデートできたA機」に届いただけで、隣の「起動に失敗して火を噴いているB機」には届いていなかったかもしれないからです。
この罠を回避するために、現場のインフラエンジニアは決してLBだけを信じて確認作業を終えません。
実務では、LBを経由させずに、検証端末のhostsファイルを書き換えるなどして、各WebサーバーのIPアドレス(RIP)を直接指定し、1台ずつ個別にアクセスして動作確認を行います。
このように、通信の経路を完全にコントロールして1台ずつ「直撃」させることで、初めて確実なリリースや正確な障害切り分けが可能になります。
ロードバランサーが絡むシステムで障害が起きたとき、あるいはメンテナンスを行うときは、以下の言葉を常に念頭に置いてください。
「パケットの流れがLBによって分散・変換されるため、LBを経由する通信の確認には細心の注意を払うべきである」
そして、トラブルが起きてから慌てないために、日頃から以下の3つの「仕様」を確認しておく癖をつけましょう。
これらが頭に入っていれば、障害時に「まずどこを切り離し、どこのパケットを追えばいいか」の戦術が瞬時に組み立てられるようになります。仕組みを学ぶだけでなく、その仕組みが実務でどう牙を剥くのか。そこまでを想定できて初めて、インフラの安定稼働を支えるプロフェッショナルと言えるのです。
▼▼▼まずはここからチェック!