【上流】現場リーダーの勘所– スキルレベル –
設計・サイジング・ベンダーコントロールなど、プロジェクトを動かす立場になったあなたへ。200台規模のサーバーを守る現役サービスマネージャーが、経営層を納得させる論理的な設計手法や、チームの出力を最大化するマネジメントの真髄を惜しみなく伝授します 。
-

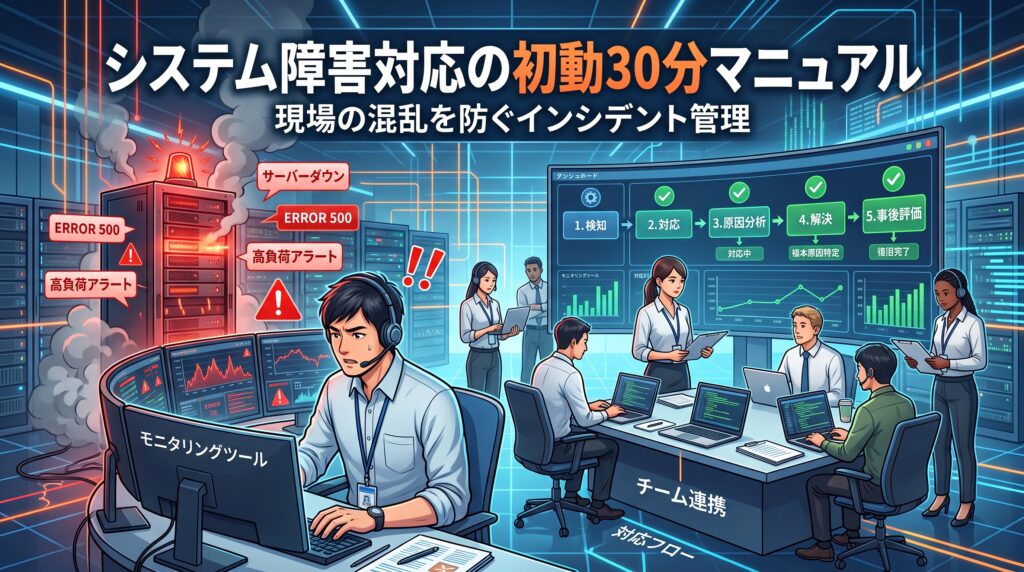
システム障害対応の初動30分マニュアル|現場の混乱を防ぐインシデント管理
深夜や休日のオンコール、あるいはアクセスが集中する日中のコアタイム。突然鳴り響くアラート通知とともに、ビジネスサイドやカスタマーサポートからチャットへ矢のような催促が飛んできます。 「〇〇サービスが落ちています!」 「管理画面にアクセスで... -
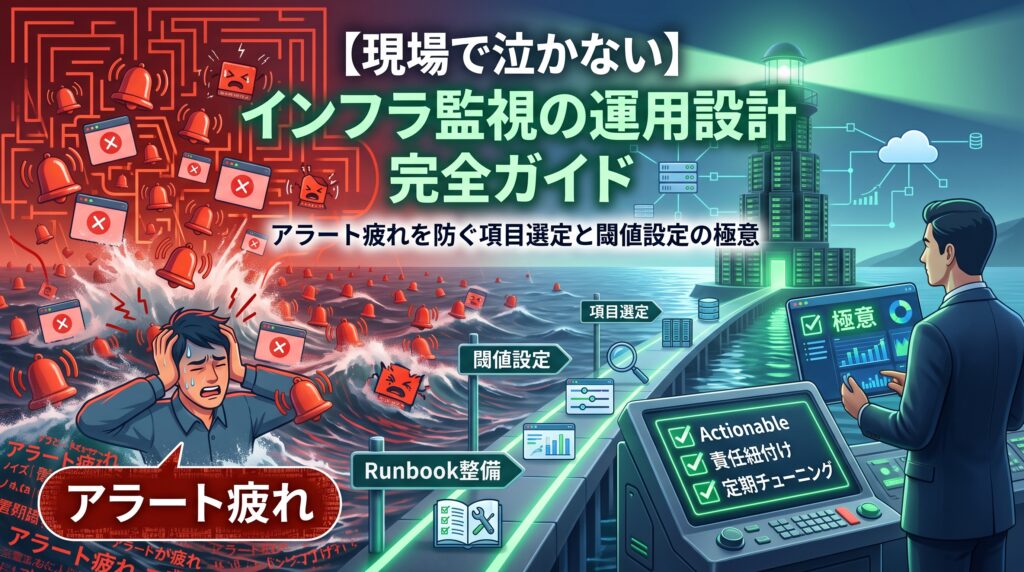
【現場で泣かない】インフラ監視の運用設計ガイド|アラート疲れを防ぐ閾値設定の極意
「深夜2時に緊急アラートで叩き起こされたが、確認したら『いつもの一時的なCPUスパイク』で静観して二度寝した」 「毎日何十通も届く監視メールを、フィルタで未読のまま専用フォルダに流している」 インフラ運用の現場で、こうした「アラート疲れ(Alert... -
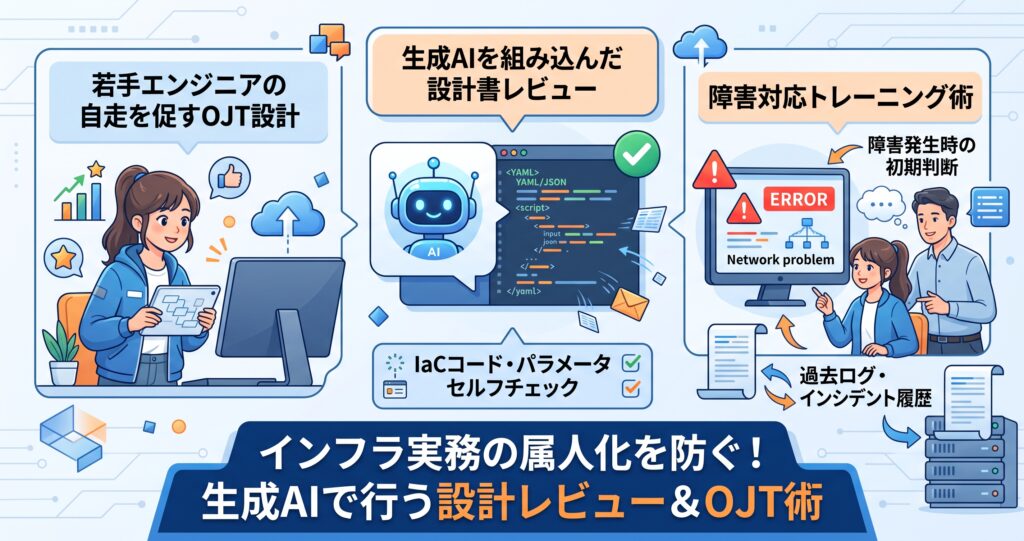
インフラ実務の属人化を防ぐ!生成AIで行う設計書レビュー&障害対応OJT術
現場の若手・中途メンバーの育成において、以下のような課題に直面していないでしょうか。 「手順書通りには動けるが、システム全体における位置づけを理解しておらず作業者目線から抜け出せない」 「過去に何度も指摘したパラメータの不整合やフォーマッ... -
インフラ運用設計の必須項目5選|運用移管トラブルを防ぐチェックリスト
「構築プロジェクトもいよいよ終盤。要件通りのシステムが組み上がり、単体・結合テストもパスした。これでようやく無事にリリースできる……!」 そう胸を撫で下ろしたのも束の間。本番公開(Go-Live)の直後から、運用保守チームから次々と問い合わせやク... -
インフラRFPの書き方とベンダー評価マトリクス|RFIとの違いも解説
こんにちは、もっちです! 私は大手SIerに18年勤務し、現在はオンプレミスやクラウドのインフラ基盤を統括するサービスマネージャーとして、日々ベンダーコントロールや設計・運用の最適化に取り組んでいます。 インフラの構築や大規模な更新プロジェクト... -
【完全ガイド】稼働率計算と許容停止時間一覧|合成可用性とエラー予算
「稼働率99.99%(フォーナイン)」を目指すと聞いたとき、それが具体的に「1か月あたり何分何秒の停止しか許されないのか」を即座に試算できているでしょうか。 単なる用語としての可用性理解から一歩踏み込み、「システム全体の合成可用性をどう計算し、S... -
【完全ガイド】SLA設計の罠と定義項目一覧|クラウド×オンプレの責任分界点
「稼働率99.99%を保証してほしい」——事業部門や顧客からのこうした要求に、頭を悩ませた経験はないでしょうか。 特にパブリッククラウドとオンプレミスを組み合わせたハイブリッド環境では、クラウド事業者の「金銭返金型SLA」とオンプレミスの「パーツ駆... -
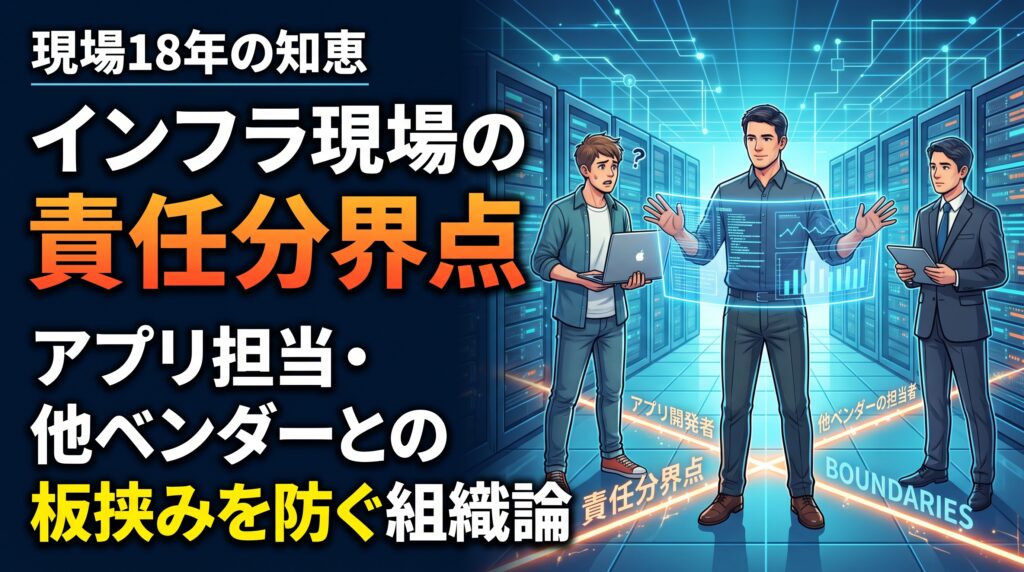
インフラ現場の責任分界点とは?アプリ担当・他ベンダーとの板挟みを防ぐ組織論
こんにちは、ブログ運営者の「もっち」です。 大手SIerにてインフラエンジニア、そしてサービスマネージャーとして18年間、オンプレミスからクラウドまで約200台の大規模インフラ基盤の設計・構築・運用保守を統括してきました。 インフラ運用の現場に身を... -
【業務効率化】インフラ設計書レビューをAIで爆速化!パラメーターシートの考慮漏れを防ぐプロンプト術
こんにちは!『となりのインフラエンジニア』の管理人です。 設計書を書き上げたとき、みなさんはどんな気持ちになりますか?「よし、完璧だ!」と思ってレビューに臨んだのに、先輩やマネージャー、あるいは組織の上位層から「この観点、 考慮漏れてない... -
ベンダーコントロールの極意|「丸投げ」で炎上させない発注・管理の実務原則
こんにちは、ブログ運営者の「もっち」です。 大手SIerにてインフラエンジニア、そしてサービスマネージャーとして18年間、オンプレミスからクラウドまで約200台の大規模インフラ基盤の設計・構築・運用保守を統括してきました。 プロジェクトリーダーやマ...