もっち
大手SIerに18年勤務。オンプレ・クラウド計200台規模の大規模インフラ(10システム)を統括する現役のサービスマネージャーです。
もっち
大手SIerに18年勤務。オンプレ・クラウド計200台規模の大規模インフラ(10システム)を統括する現役のサービスマネージャーです。
▼▼▼まずはここからチェック!
「深夜のカットオーバー作業、予定時刻を過ぎても新ネットワークで疎通が取れず、切り戻すべきか判断が遅れて翌朝の業務開始に間に合わなかった……」
「ベンダーから提出された障害試験結果に『疎通確認:OK』としか書かれておらず、本番稼働後に片系回線が落ちた際、長時間のセッション断が発生して大クレームになった……」
「リプレイス完了後にネットワーク運用設計書が形骸化し、初動対応で障害切り分けに何時間もかかってしまった……」
基幹ネットワークや拠点LAN、データセンターのリプレイスプロジェクトにおいて、成否を決定づけるのは最新スイッチやルータのスペックではありません。
すべては「最悪の事態を想定した移行計画・切り戻し設計ができているか」、そして「障害試験でどれだけ異常系の弱点を炙り出せたか」にかかっています。
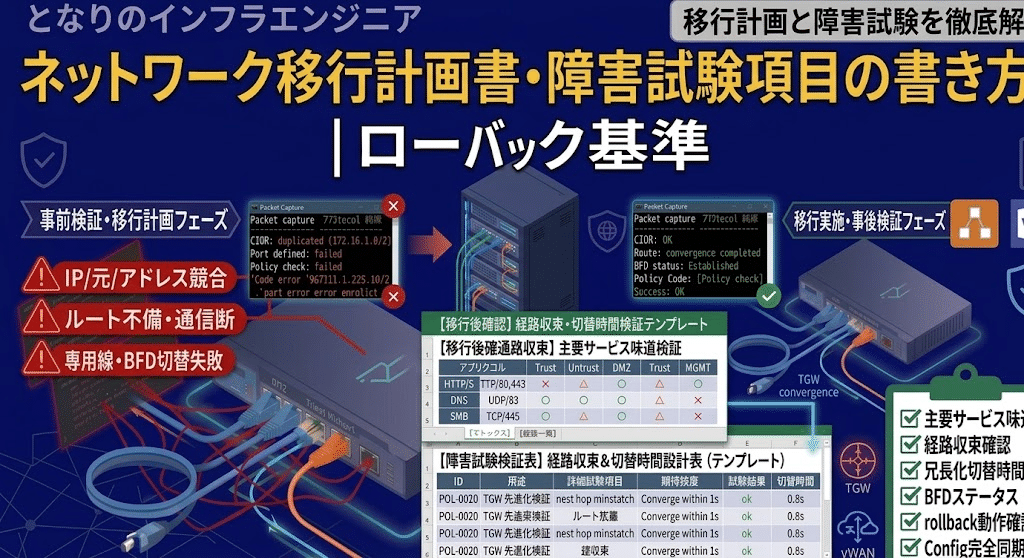
本記事では、発注側(情シス・PM)および構築ベンダー双方の視点から、炎上を防ぎ、手戻りゼロで本番移行を成功させるための「ネットワーク移行計画書」「受入・障害テスト仕様書」「運用保守設計書」の実務作成手順と合否判定基準を徹底解説します。
この記事の想定読者
この記事を読むことでのメリット
本記事は、基本設計・詳細設計(構成図、IP・ポート、通信マトリクス、ハイブリッド接続)を経て迎える「最終フェーズ(検証・移行・運用)」の解説です。シリーズ全体のロードマップは以下の親記事をご覧ください。
ネットワークの品質検証から本番移行、その後の運用保守を破綻させないための大原則は以下の4点です。
最新機器を導入し、机上設計を綿密に行ったはずのプロジェクトが、なぜ本番切替当日やカットオーバー直後に炎上してしまうのか。現場で繰り返し発生している3大要因を整理します。
最も多い失敗が、「各機器の設定を入れてPingが通ったから合格」としてしまうケースです。
深夜のメンテナンス時間帯は、ネットワーク上に本番トラフィックが流れていません。そのため、以下のような問題が試験環境では完全に隠蔽されます。
「予定時刻を30分オーバーしているが、あと少しで原因が分かりそうだから作業を続行しよう」
この正常性バイアスによる判断の遅れが、翌朝の全社業務停止事故を引き起こします。
「何時までに疎通が確認できなければ切り戻すか」のデッドラインが手順書に明記されていない現場では、誰も責任を持って「ロールバック」を宣言できません。
結果として、切り戻し作業中に始業時刻を迎え、未完了の状態で社員が出社してくる最悪のシナリオに突入します。
構築プロジェクトチームは「カットオーバー完了」で役目を終えますが、システムのライフサイクルから見ればそこがスタート地点です。
これらはすべて、設計フェーズで「運用保守設計書」を軽視したツケが運用現場に回った結果です。
本番切替当日の現場は、深夜の疲労と予期せぬトラブルで極限状態に陥ります。移行計画書には、「思考停止状態でもミスなく進められる具体性」が求められます。
メンテナンスウィンドウは、単に「業務停止時間」を割り振るのではなく、「事前準備」「本番作業」「確認試験」「切り戻しバッファ」の4ブロックで構成し、図解などで可視化します。
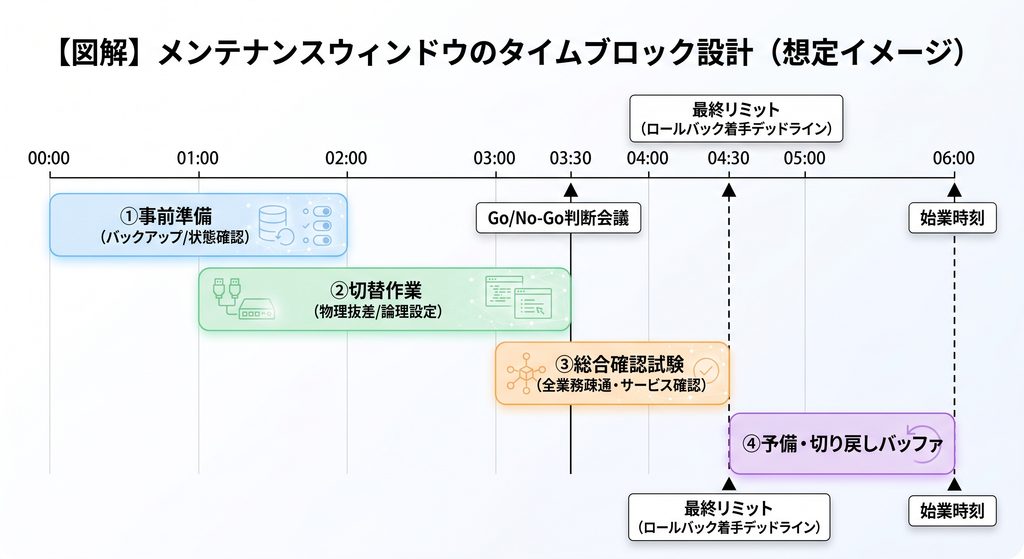
ダウンタイムを秒単位・分単位に抑えるための上流設計テクニックを作業手順書に盛り込みます。
65535)に引き上げる、あるいはBGPでAS-Path Prependを付加して広報する。切り戻し判断時刻は、「何時になったら切り戻すか」を感覚で決めてはなりません。強調スニペットへの採用率を高めるため、以下の逆算式を用いて厳密に算出します。
【公式】ロールバック着手デッドラインの算出
切り戻し着手デッドライン = 業務再開目標時刻 − (切り戻し作業時間 + 切り戻し後確認試験時間 + 安全バッファ)
この計算式に基づき、手順書には具体的なタイムスケジュールを定義します。
【ロールバック限界時刻の計算例】

・翌朝の業務再開目標時刻: 07:00
・切り戻し作業時間(旧結線復帰・Configリストア): 60分
・切り戻し後の最低限の疎通確認時間: 30分
・予備安全バッファ: 30分
─────────────────────────────────────────────
 合計所要時間 = 60分 + 30分 + 30分 = 120分(2時間)

 ★ロールバック着手の絶対デッドライン = 07:00 − 2時間 = 【 05:00 】
この計算により、「午前5:00の時点で総合確認試験が完了していなければ、原因究明の途中であっても無条件で切り戻しを開始する」という冷徹なルールを手順書に明記し、Go/No-Go判断会議での合意形成に役立てます。
作業手順書(Runbook)のタイムチャート例です。
| 時刻 | 所要 | 作業項目 | 主担当 | 確認者 | 判定基準 / コマンド | ロールバック手順 |
| 01:00 | 15分 | 旧機器の最新Configバックアップ取得 | 担当A | PM | MD5ハッシュ値一致確認 | 取得失敗時は作業中断 |
| 01:15 | 15分 | 現行ルーティング状態の保存 | 担当A | 担当B | show ip route > route_before.txt | – |
| 01:30 | 30分 | 新コアスイッチへの物理アップリンク結線 | 担当B | 担当A | ポートLink Up、エラーパケットゼロ | 旧ポートへ物理結線を戻す |
| 02:00 | 30分 | 新ルータのBGP/OSPFネイバー確立 | 担当A | 担当B | show ip bgp summary (State: Established) | 新ルータポートをshutdown |
| 02:30 | 60分 | 業務系・インターネット疎通確認 | 試験班 | PM | 全拠点代表端末からのPing/HTTP疎通 | 04:30までに未達なら切り戻し |
| 04:30 | 15分 | 【Go/No-Go判断会議】 | 全員 | 統括PM | 全試験項目の合否判定シート確認 | No-Go時は直ちに全系ロールバック |
| 04:45 | 15分 | 新環境稼働確定・監視再開 | 担当A | 運用班 | 監視マネージャでの全ノードGreen確認 | – |
ネットワークの信頼性を担保するためには、テストを「単体機能」「結合負荷」「疑似障害」の3フェーズに明確に分離して仕様書を作成します。
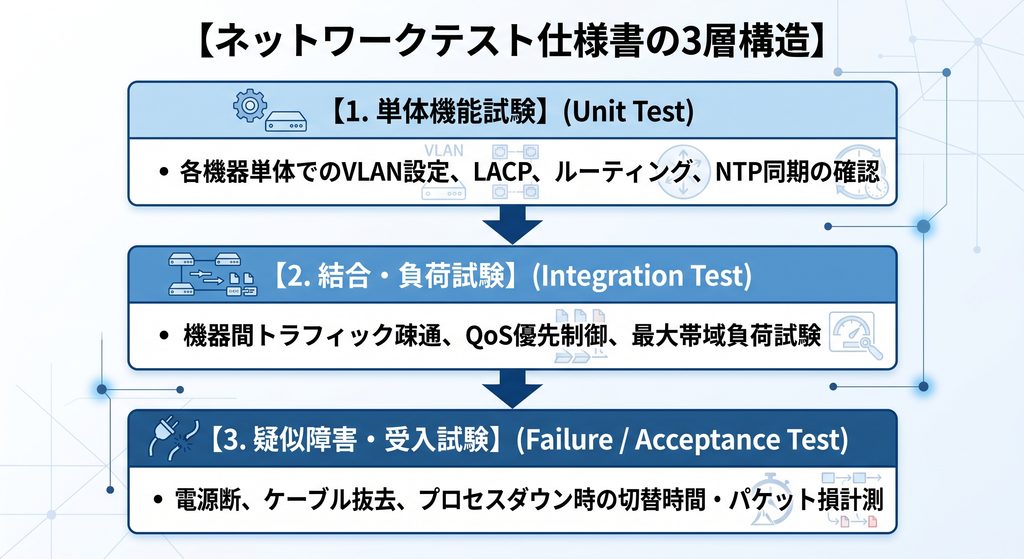
障害試験では、「機器が完全に壊れるケース」だけでなく、「中途半端に通信が不安定になるケース」まで網羅することが不可欠です。専門用語の意味を要約しながら表形式で整理します。
| 障害分類 | 試験シナリオ | 模擬障害の発生手法 | 確認ポイント | 要するに?(PM・情シス向け補足) |
| 物理障害 | 電源片系障害 | 二重化電源ユニットの片側ACケーブル抜去 | 機器が再起動せず稼働継続するか、電源アラートがSNMP/Syslogで発報されるか | 1つの電源故障でも業務が止まらないことの確認 |
| 物理障害 | 物理リンクダウン | 冗長トランク(LACP)のLAN/光ケーブル抜去 | LACPの縮退動作(複数ケーブルが1本になっても通信継続)、残ポートへのトラフィック瞬時集約 | ケーブル断時の経路集約の確認 |
| 物理障害 | トランシーバー障害 | SFP/SFP+モジュールの半挿し・抜去 | リンクフラッピング(Link Up/Downの短時間の繰り返し)が起きず確実にLink Downとして処理されるか | ポート故障時の確実な閉塞( Err-Disable )の確認 |
| 論理障害 | デフォルトGW切替 | VRRP/HSRPマスタ機器のシャットダウン | バックアップ機への仮想IP(VIP)昇格、GARP送出によるスイッチMAC学習 | ゲートウェイ冗長化のフェイルオーバー(予備機への切替)の確認 |
| 論理障害 | ルーティング障害 | 対向ルータのOSPF/BGPプロセスキル | 迂回経路へのダイナミックルーティング収束時間(経路再計算時間)、ルーティングループ(ルート循環)の有無 | ネットワーク全体での経路収束速度の確認 |
| サイレント | 片方向通信障害 | 光ファイバーのTx(送信芯)のみ切断 | UDLD(Unidirectional Link Detection)等によるポート自動閉塞(Err-Disable) | 「上りはOK、下りはNG」のような不安定な状態を検知できるか |
| サイレント | クラウド回線遅延 | 専用線(DX/ER)のパケットロス発生 | BFD(双方向フォワーディング検出)による1秒未満でのバックアップ迂回 | 「回線故障」として認識されない遅延・パケロスをBFDで超高速検知できるか |
障害試験の合否判定において、「目視でPingが通っていたから合格」は絶対にNGです。
試験仕様書には、以下の表のように「許容ダウンタイム(パケットロス秒数)」を数値で定義し、測定機器(パケットテスターやWireshark)を用いた客観的エビデンスの採取基準を設けます。
| 通信カテゴリ | 対象トラフィック | 目標切替時間 | 許容パケットロス基準 | 合否判定基準 |
| 音声・映像 | VoIP(IP電話)、Web会議 | 1秒未満 | 0〜1パケット (0.1秒間隔送信) | 通話が切断されず、明らかなノイズや音途切れが発生しないこと |
| 基幹業務系 | DBアクセス、ERP、勘定系 | 3秒以内 | 30パケット以内 (0.1秒間隔送信) | TCPセッションがタイムアウトせず、再送制御で業務画面が復旧すること |
| Web・一般 | 社内Web、ファイル共有 | 5秒以内 | 50パケット以内 (0.1秒間隔送信) | ブラウザのリロードなしで画面描画が完了すること |
| 管理・監視 | SNMP、Syslog、SSH | 30秒以内 | セッション再接続可 | 切替完了後に管理端末から再ログイン可能であること |
リプレイス後の障害対応スピード(MTTR)は、運用設計の精度で決まります。
すべての事象をアラート通知すると、運用担当者が通知を無視するようになります。
「Severity(重要度)」に応じた3段階の通知設計を仕様書に定義します。要するに、オオカミ少年化を防ぎ、真の異常への初動を早めるための設計です。
【ネットワーク監視の3段階フィルタリング設計】

 [ 重要度:Critical (即時電話呼出 / エスカレーション) ]
  ・機器完全ダウン (ICMP Ping死活監視不通 3回連続)
  ・電源ユニット障害、ファン故障
  ・アップリンク回線の全断 (BGPネイバーダウン)
               │
 [ 重要度:Warning (チャット通知 / 当日日中対応) ]
  ・二重化回線の片系ダウン (片肺運転状態)
  ・ポートのLink Flapping (短時間のUp/Down繰り返し)
  ・CPU/メモリ使用率 80%超過 (5分継続)
  ・帯域使用率 85%超過 (QoS優先制御の閾値検討)
               │
 [ 重要度:Info (ログ蓄積のみ / 月次レビュー) ]
  ・管理者ログイン (SSH/Console)
  ・設定変更ログ (Configured from console)
  ・NTP時刻同期完了
障害発生時、ログのタイムスタンプが1秒でも狂っていると、複数機器にまたがるパケット追跡が不可能になります。要するに、時刻を厳密に合わせ、Configを自動保存する仕組みが必要です。
ネットワーク刷新プロジェクトがカットオーバーした直後、運用保守現場で最も多発するトラブルが「障害発生時の責任境界の押し付け合い(たらい回し)」です。
拠点からクラウドへの通信が不安定になった際、運用手順が標準化されていないと、以下のような初動の混乱が確実に発生します。
こうした事態を防ぎ、障害検知から「5分以内」に問題箇所を特定して初動アクションへ繋げるための「一次切り分け判断フロー(フローチャート)」を運用設計書へ必ず組み込みます。
近年、ネットワークの構築・運用にもIaCの導入が進んでいます。しかし、現場では「設計書(Excel)とコード(Terraform/Ansible)の二重管理」という新たな課題が生まれています。
そのため、設計書、コード、実機設定を100%一致させ続ける仕組みが不可欠です。
エンジニアが障害対応時に現場判断で実機に直接CLIコマンドを投入してしまうと、Gitリポジトリ上のコードや設計書との間に「乖離(Configuration Drift、実機設定と定義の不一致)」が発生します。
これを放置すると、次回のリストア実行時に「緊急変更した設定が勝手に上書きされて巻き戻る」という大事故につながります。
IaC時代のネットワーク設計書は、「静的な納品物」ではなく「コードの元データ、あるいはコードから自動出力されるドキュメント」へと進化させる必要があります。
これにより、「設計書・コード・実機設定」の3者が常に100%一致する堅牢な構成管理( GitOps 運用 )が実現します。
ネットワークの移行と運用は、華々しい設計思想を「絶対に止まらない現実のインフラ」へと具現化する最終防衛ラインです。
カットオーバーの直前に、以下の重要項目が計画書・仕様書に盛り込まれているか必ず再点検してください。
| カテゴリ | チェック項目 | 確認 | 要するに?(PM・情シス向け補足) |
| 移行計画 | 切り戻し着手デッドライン(切り戻し限界時刻)が業務再開時刻から厳密に逆算されているか | □ | 始業に間に合わせるための「切り戻しリミット」が明確か |
| 移行計画 | DNSのTTL短縮やARPキャッシュのフラッシュ手順( Gratuitous ARP送信 )が漏れなく記載されているか | □ | 切替・切り戻し時の端末通信復旧がスムーズに行われるか |
| 移行計画 | 作業当日の役割分担(作業者・確認者・統括PM・判断権限者)とエスカレーション体制図が明確か | □ | 予期せぬトラブル時に誰がGo/No-Goを判断するか決まっているか |
| テスト仕様 | 物理障害だけでなく、論理障害(BGP/OSPF)、サイレント障害(パケロス/BFD)のシナリオが含まれているか | □ | 中途半端な障害状態でも迂回経路が機能するか確認したか |
| テスト仕様 | 「Ping疎通」だけでなく、パケットロス許容時間(秒数)が合否基準にあるか | □ | 業務アプリが切断されない「客観的な切替秒数」を測ったか |
| テスト仕様 | ステートフル機器(FW/LB)のセッション引き継ぎ試験(アクティブ機停止時)が計画されているか | □ | FWのセッション同期が不備で通信遮断が起きないか確認したか |
| 運用保守 | 監視通知(SeveriryCritical/Warning)が適切にフィルタリング(オオカミ少年化防止)されているか | □ | 重要でないアラートに埋もれず、真の異常への初動を早める設計か |
| 運用保守 | ログ解析のために全機器の時刻同期(NTP冗長化、Stratum2〜3)が定義されているか | □ | 障害調査で全機器のタイムスタンプが一致するか |
| 運用保守 | 一次切り分けフローチャートと保守ベンダーへの通報手順書(24/7オンサイト等)が完備されているか | □ | MTTR(平均復旧時間)を最小化する運用準備ができたか |
ネットワークエンジニアにとって、本番切替作業の成功ほど誇らしい瞬間はありません。
しかし、真に優秀なエンジニアやプロジェクトマネージャーは、「絶対に成功させる」と意気込むと同時に、「万一のトラブル発生時に、誰一人パニックにならず、いかに冷静かつ美しく元の状態へ切り戻せるか(ロールバックデッドラインの遵守)」のシミュレーションに心血を注ぎます。
最悪の事態を想定し尽くした計画書があるからこそ、現場は自信を持って本番のレバーを引くことができます。
本記事で解説した検証フレームワークと切替計画を武器に、貴社のネットワーク移行プロジェクトをトラブルゼロで完遂させてください!
▼▼▼まずはここからチェック!