もっち
大手SIerに18年勤務。オンプレ・クラウド計200台規模の大規模インフラ(10システム)を統括する現役のサービスマネージャーです。
もっち
大手SIerに18年勤務。オンプレ・クラウド計200台規模の大規模インフラ(10システム)を統括する現役のサービスマネージャーです。
▼▼▼まずはここからチェック!
「本番環境でアラート発報、サービスが応答していません!」
監視ツールからの通知が鳴り響いた瞬間、現場には特有の緊張が走ります。ログの調査、プロセスの確認、切り戻し手順の検討……。やるべき作業が山積みになる中で、多くの現場で最も後手に回り、のちに大きな炎上を引き起こすのが「関係者への状況報告」です。
「まだ原因が分かっていないから報告できない」
「調査に集中したいから、状況が整理されてから連絡しよう」
この判断が命取りになります。障害対応において、顧客や社内ステークホルダーが最も不安を感じ、不信感を募らせるのは「システムが止まっていること」そのものよりも、「今何が起きていて、どう対処されているのかが全く見えない(ブラックボックス化している)状態」です。
インシデント対応の成否は、技術的なトラブルシュート力だけでなく、「報告のスピードと透明性」で決まります。
この記事では、障害発生から暫定復旧、そして事後対応に至るまでの「インシデント報告の標準フロー」「発生15分以内に出すべき第1報フォーマット」「重要度に応じたエスカレーション基準」を体系的に解説します。
この記事の想定読者
この記事を読むことでのメリット
トラブル発生時のコミュニケーション不全は、容易に二次災害を生みます。まずは現場が混乱に陥る典型的なパターンと、押さえるべき全体のタイムラインを整理します。
日常のインフラ業務における報連相では、「事実」「解釈」「行動」をセットでロジカルに伝えるコミュニケーションが非常に有効です。
※日常業務での論理的な伝え方や思考の整理法については、以下の記事で詳しく解説しています。
しかし、インシデント発生時の初動においては「解釈(個人の推測や推論)」はノイズであり、時に判断を狂わせるリスクになります。
「〜のバグかもしれません」「30分で直ると思います」といった不確定な推測を報告に混ぜてはいけません
。有事の初動報告では解釈を極限まで削ぎ落とし、「客観的に確認された事実」と「現在行っているアクション」だけに絞り込むのが鉄則です。
インシデント報告は、対応フェーズに応じて以下の4段階で進めます。
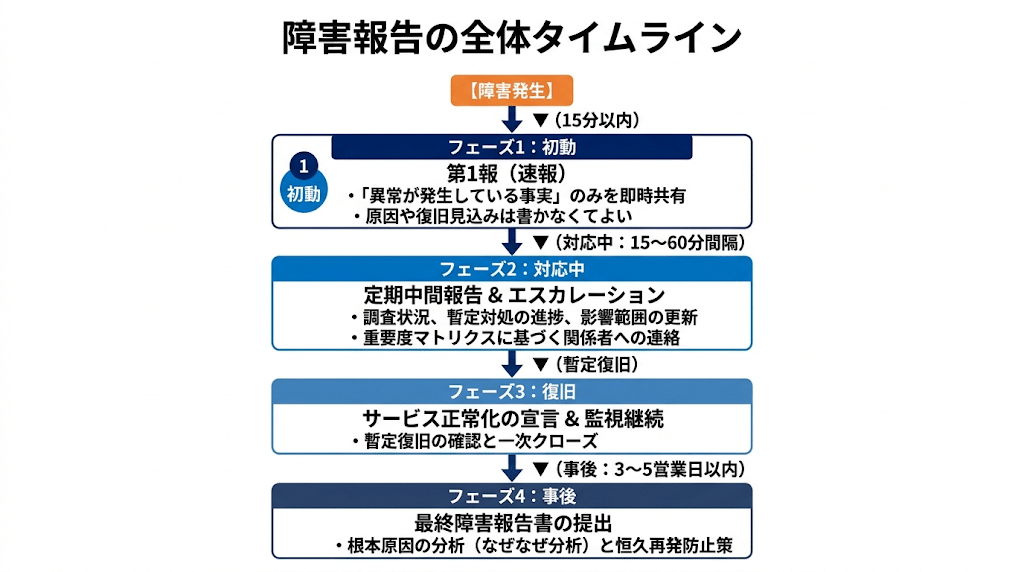
インシデント検知後、「15分以内」に関係者・ステークホルダーへ第1報を発信します。
ここでの目的は「問題解決」ではなく、「異常を検知し、チームが対応を開始したという事実を認知させること」です。
初動の速報では、調査結果を詳しく書く必要はありません。以下の4点だけに絞って発信します。
【第1報の必須4項目】
- 検知時刻:何時何分にアラートを受信・検知したか
- 対象サービス・範囲:どのシステム・機能に異常が出ているか
- 現在の状況(事実):エラー急増、応答停止などの客観的ステータス
- ネクストアクション:現在誰が何を調査中で、次回は何時に報告するか
原因、影響ユーザーの確定数、復旧見込み時刻などは、第1報の段階では「調査中」で構いません。スピードを最優先します。
社内チャットや障害通知チャンネルへそのまま投稿できる基本テンプレートです。
【障害速報・第1報】◯◯システム サービス影響について

■ 検知日時:YYYY/MM/DD HH:MM
■ 対象サービス:◯◯基幹連携API / Webフロントエンド
■ 障害ステータス:一部機能停止(エラーレート急増)
■ 事象概要(事実のみ):
監視アラート「HTTP 5xx Error Rate High」を検知。
現在、ユーザー向け管理画面へのアクセスが不安定な状態となっています。

■ 現在の対応状況:
インフラ運用チームにて直近のリリース状況確認およびアクセスログの切り分けを実施中。

■ 次回報告予定:
HH:MM(発生から30分後を目安)に第2報を共有します。
初動を出した後は、復旧作業と並行して「適切な相手へのエスカレーション」と「定期的な中間報告」を回します。
すべての障害を同じ熱量でエスカレーションすると、組織全体が「アラート疲れ」を起こします。
影響度(業務停止の度合い)と緊急度(顧客・金銭的インパクト)に応じてレベルを定義し、報告先を自動的に決定します。
| 重要度レベル | 定義・影響範囲の目安 | 主なエスカレーション先 | 報告頻度 |
| Sev-1(最重要) | 全面サービス停止、データ損失リスク、全ユーザー影響 | 経営層、事業部長、全社、広報・顧客サポート | 15〜30分毎 |
| Sev-2(重要) | 主要機能の一部停止、冗長構成の片肺運転、一部ユーザー影響 | 開発リーダー、プロダクトオーナー、運用担当 | 30〜60分毎 |
| Sev-3(軽微) | 管理画面の軽微な表示崩れ、影響軽微なバッチ遅延 | 担当チーム内、関連エンジニア | ステータス変化時 |
現場で最も多い失敗が、「進展がないから報告をスキップする」ことです。
しかし、報告を待つ側からすると「約束の時間を過ぎても連絡がない=対応が難航している、あるいは放置されているのではないか」という強い不安を生みます。
進展がない場合でも、約束した時刻が来たら定刻通りに発信します。
進展なし報告の文例
「HH:MM現在の中間報告です。エラーログの切り分けを継続していますが、現時点で根本原因の特定には至っていません。現在、直近で適用された設定変更のロールバックを検証中です。次回はHH:MMに状況を共有します。」
「進展がない」という事実と「次に何を試しているか」を共有するだけで、周囲の安心感は保たれます。
1人のエンジニアがトラブルシュートをしながら、顧客や社内からの個別問い合わせに追われていると、作業ミスを誘発し復旧が大幅に遅れます。Sev-2以上の障害では、速やかに役割を分担します。
役割を物理的に分離することで、現場の調査リソースを守り、かつ迅速な情報発信が両立できます。
サービスが復旧した際も、雑に終わらせてはいけません。
プロセスの再起動やトラフィックの迂回(切り戻し)によってサービスが息を吹き返した段階は、あくまで「暫定復旧(Workaround適用)」です。
報告には以下の3点を明確に記載します。
暫定復旧直後に「復旧しました。完了です!」と気を緩めると、キャッシュの再生成やトラフィックの集中によって障害が再発(揺り戻し)することが多々あります。
報告文言には必ず「監視強化フェーズ」を設ける旨を明記します。
「HH:MMにサービスの正常化を確認しました。トラフィックの揺り戻しに伴う再発を防止するため、今後2時間は監視体制を強化します。異常がなければHH:MMをもって一時クローズといたします。」
サービスが安定し、インシデント対応の現場が一息ついたら、最後の重要工程である「障害報告書(事後報告)」の作成フェーズに移ります。
一般的に、インシデント発生後の報告スケジュールは以下の2段階で進めるのが標準的です。
| 報告種別 | 提出目安 | 主な目的 |
| 一次報告(中間まとめ) | 復旧後 24時間以内 | 障害の確定タイムライン、ダウンタイム、暫定対処内容、確定影響件数の報告 |
| 最終障害報告書 | 復旧後 3〜5営業日以内 | 詳細ログ解析に基づく根本原因の特定、組織的・技術的な恒久再発防止策の提示 |
最終報告書を作成する際、多くのエンジニアが上長や顧客から厳しい差し戻しを受けます。
初動連絡をどれだけスピーディにこなしても、事後対応の報告書で「精神論」や「形骸化した対策」を書いてしまうと、組織やチームの技術的信頼は失墜してしまいます。
承認者をうならせる報告書を書くには、技術・運用・組織の3系統で掘り下げる「なぜなぜ分析」と、ヒューマンエラーを物理的に排除する「技術的ガードレール」の提示が不可欠です。
差し戻しをゼロにし、顧客や上長から一発承認をもらうための「実践的ななぜなぜ分析」「再発防止策の3層構造」、そのままコピペして使えるMarkdownテンプレートについては、以下の記事で実例付きで詳しく解説しています。
システム障害が発生した現場は、誰しもパニックに陥りやすいものです。
その極限状態の中で「誰が、いつ、どこへ連絡すべきか」を個人の裁量に委ねていては、報告の遅れや連絡漏れを避けることはできません。
このプロセスをあらかじめルールとして仕組み化しておくことこそが、エンジニアが安心して技術調査に集中できる環境をつくり、結果としてシステムと組織の信頼性を守る最大の武器になります。
▼▼▼まずはここからチェック!