もっち インフラエンジニア / ITサービスマネージャー
24時間365日の監視オペレーターからキャリアをスタート。設計・構築を経て、現在は8名チームのリーダーとしてミッションクリティカルな基盤運用を統括しています。
もっち インフラエンジニア / ITサービスマネージャー
24時間365日の監視オペレーターからキャリアをスタート。設計・構築を経て、現在は8名チームのリーダーとしてミッションクリティカルな基盤運用を統括しています。
「また差し戻しか……」
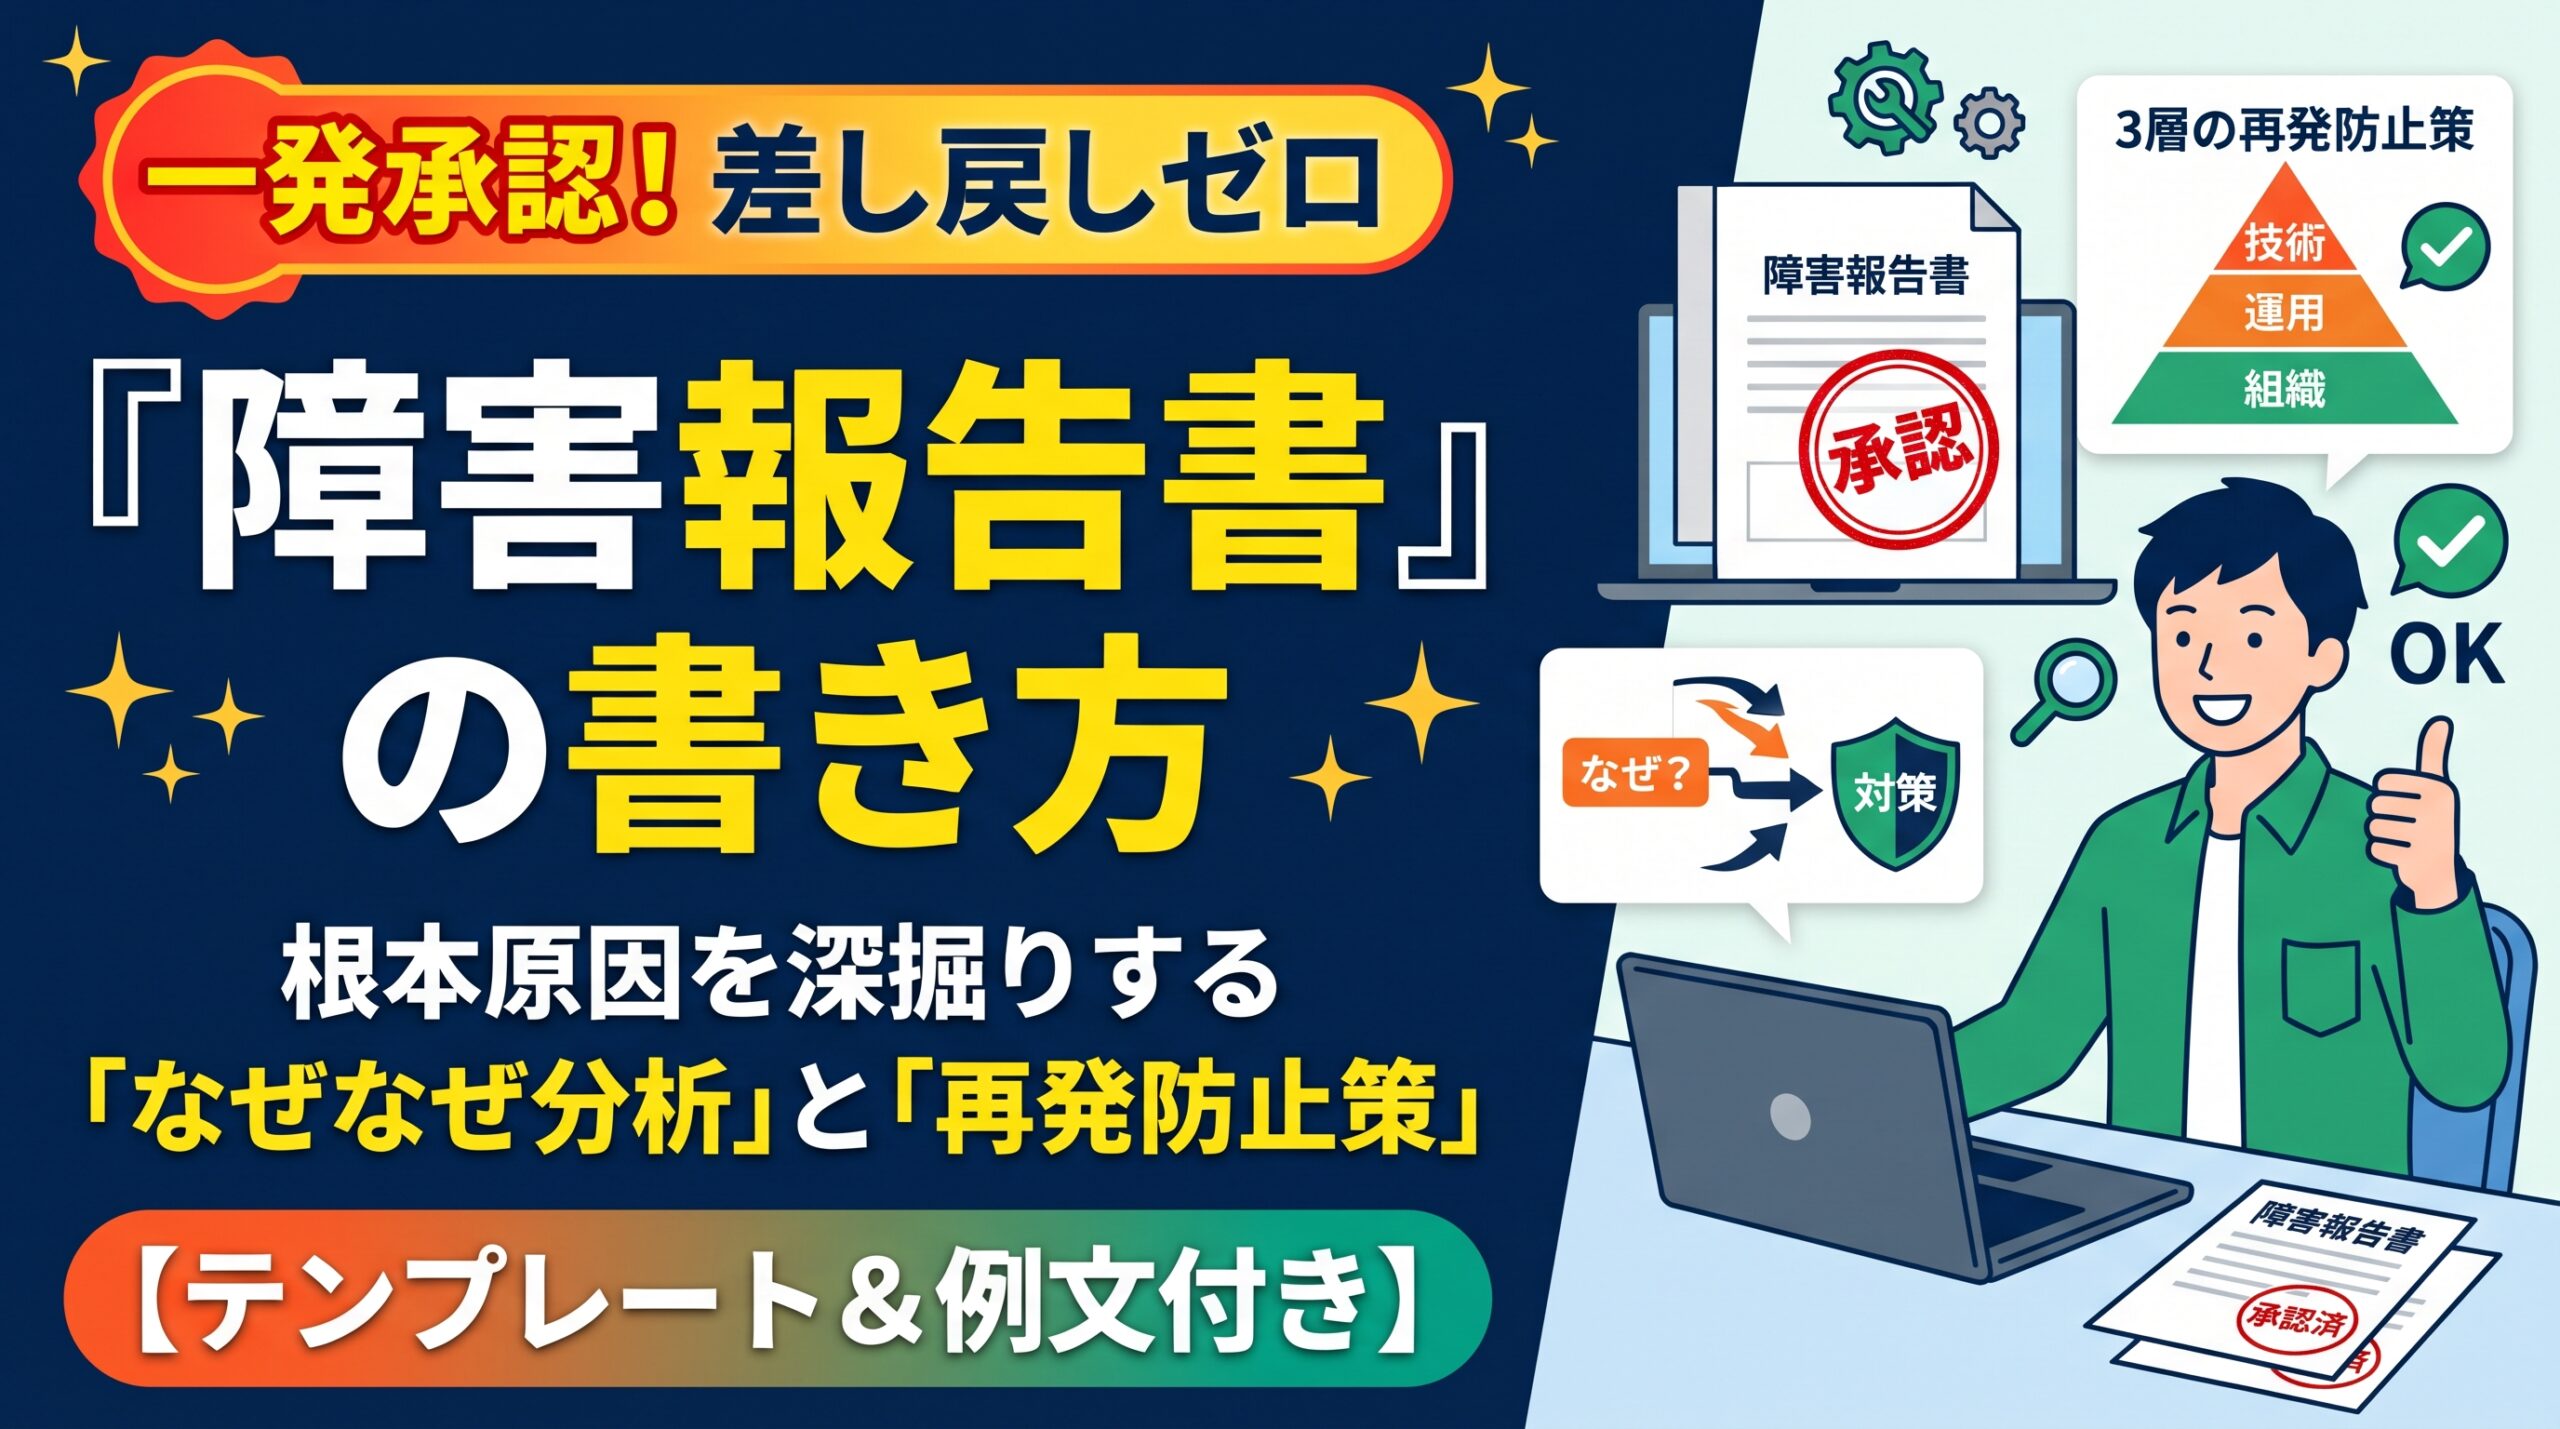
深夜や休日の緊急トラブルをなんとか鎮火させ、疲労困憊のなか書き上げた障害報告書。それを上長や顧客に提出した瞬間、こんな言葉で突っ返された経験はないでしょうか。
障害対応の初動をどれだけ迅速にこなしても、事後対応である「障害報告書」の精度が低いと、エンジニアや運用チームの信頼は一瞬で失墜します。
障害発生直後の「15分以内の第1報ルール」や「エスカレーション判断基準」などの初動対応プロセスについては、以下の記事で解説しています。
本記事では、サービスが復旧した後の「事後対応(恒久対策)」に焦点を当てます。
顧客や上長が一発で納得する「障害報告書の書き方」、現場で形骸化させない「なぜなぜ分析の実践手法」、そして「そのままコピペして使えるMarkdownテンプレートと例文集」を余すところなく公開します。
この記事の想定読者
この記事を読むことでのメリット
障害報告書が突き返される理由は、文章の上手い下手ではありません。原因と対策の「深さ」と「論理の整合性」に致命的なズレがあるからです。まずは、現場で頻発する典型的なNGパターンを把握しましょう。
これらは対策ではなく「個人の反省文」です。人間である以上、どれだけ気をつけても疲労、焦り、体調不良でミスを犯します。
精神論で書かれた対策は、承認者から見れば「ミスが起きる環境はそのまま放置します」と宣言しているのと同義です。
確認ステップを安易に増やすと、確認作業そのものが形骸化し、「誰かが確認してくれただろう」という責任の分散(傍観者効果)を招きます。さらに運用工数だけが跳ね上がり、現場の首を絞める結果になります。
「コマンドを誤入力した」のは、引き金となった直接原因(Direct Cause)であって、根本原因(Root Cause)ではありません。
「なぜ誤入力できる権限のまま作業していたのか」「なぜ事前検証で気付けなかったのか」という背景の欠陥に踏み込んでいなければ、報告書として成立しません。
承認者が報告書をチェックするとき、頭の中にある基準は極めてシンプルです。
承認者がストレスなく読める報告書には、決まった「型」があります。独自フォーマットで書くのではなく、以下の6つの要素を論理的に接続して記述します。
| 項目 | 記載すべき内容 | 記述のポイント |
|---|---|---|
| 1. 発生日時・復旧日時 | 障害検知時刻、初動開始時刻、暫定復旧時刻、完全復旧時刻 | 停止時間(ダウンタイム)を明確にし、タイムラインを客観的に示す |
| 2. 影響範囲 | 影響を受けたシステム、サービス、顧客数、データ破損の有無 | 定量的に記載する(例: 「API停止により約1,200件のリクエストがエラー」) |
| 3. 障害事象と暫定対応 | どんな現象が起きたか、サービス復旧のために何を行ったか | Workaround(切り戻し、プロセス再起動など)を時系列で淡々と書く |
| 4. 直接原因 | 障害のトリガーとなった事象・操作・バグ | 「何が起きたか」を技術的事実に基づいて客観的に書く |
| 5. 根本原因 | なぜそのトリガーが発生し、なぜ事前に防げなかったのか | 後述する「なぜなぜ分析」でプロセスや構造の欠陥を特定する |
| 6. 恒久対策(再発防止策) | 同種障害を二度と発生させないための構造的・プロセスの改善 | 担当者、実装期日、完了基準(KPI)を明記する |
報告書で最もやってはいけないのが、「原因と対策の論理的なねじれ」です。
【ねじれの例】
根本原因:ステージング環境と本番環境のOSバージョン差異によるライブラリ不整合
再発防止策:作業手順書のレビューを2名体制で実施する
これでは「環境の差異」に対して「レビュー強化」という対策が当たっておらず、承認者は「本当にこれで防げるのか?」と不信感を抱きます。
この1対1の対応関係が美しい一本のラインで結ばれているか、提出前に必ず確認してください。
根本原因を掘り下げる手法として定番の「なぜなぜ分析」ですが、現場ではしばしば形骸化し、チームを疲弊させます。
なぜなぜ分析を現場で機能させるコツは、1本の線で深く掘るのではなく、「3つの系統」に分けて多角的に掘り下げることです。
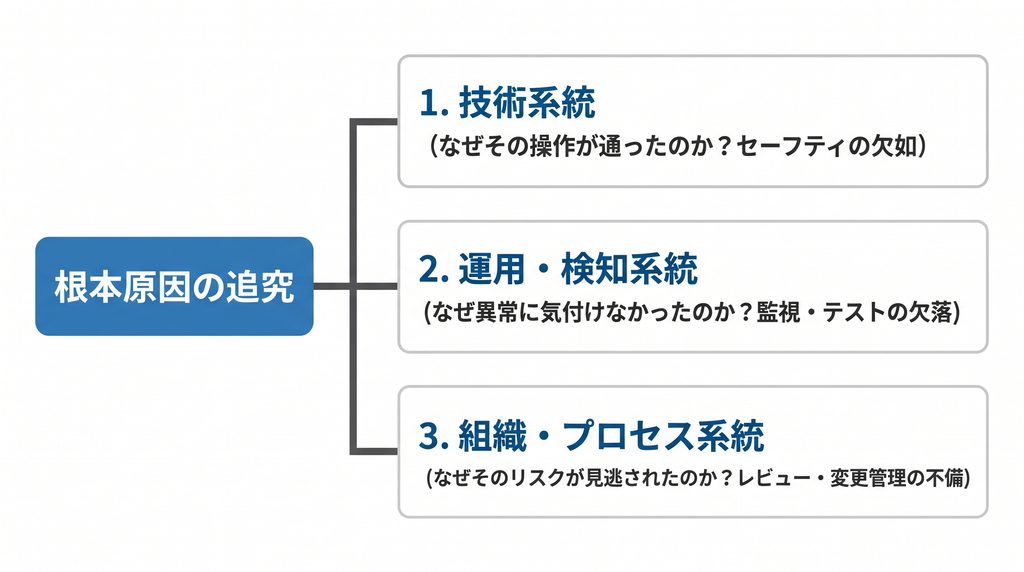
「夜間メンテナンス中、不要ログを削除しようとして誤って本番DBのデータファイルを消去してしまった」というインシデントを例に比較してみます。
系統1:技術的な掘り下げ
root(管理者権限)で作業できる設計になっていた。rm -rf, DROP等)は実行制御スクリプトを噛ませ、特権昇格が必要な設計へ改修。系統2:運用・検知の掘り下げ
系統3:組織・プロセスの掘り下げ
根本原因が特定できたら、再発防止策を組み立てます。承認者をうならせる報告書は、対策が単一の打ち手ではなく、「多層防御(3層構造)」で提示されています。
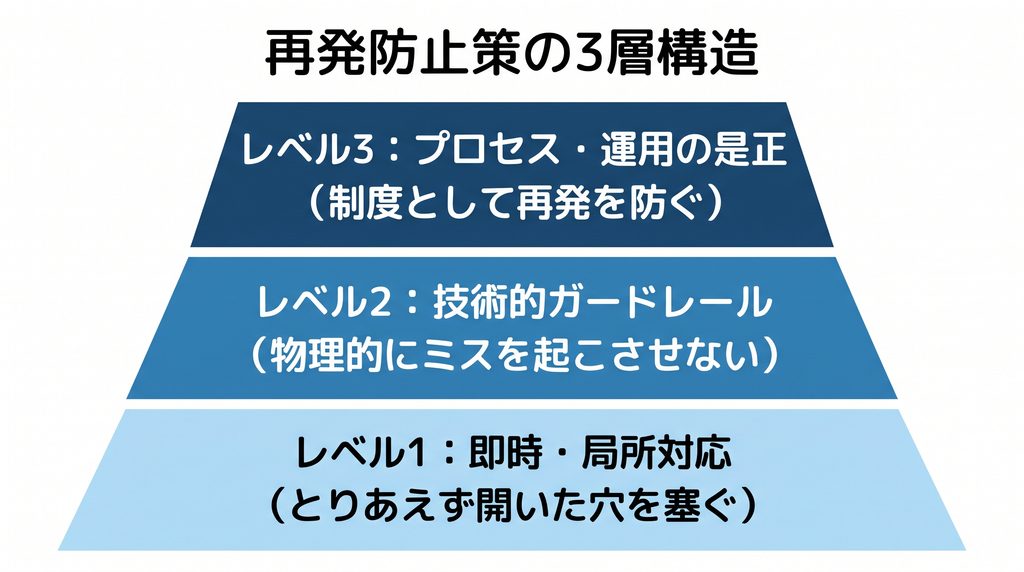
現場でそのまま流用・参考にできる、よくある障害シナリオごとの対比表です。
| 障害の直接原因 | 突っ返されるNG例文(精神論) | 承認されるGood例文(3層構造) |
|---|---|---|
| 本番DBの誤更新 | 作業手順を再確認し、以後は落ち着いて慎重にコマンドを実行する。 | 【技術】 本番DBへの直接更新権限を剥奪し、CIパイプラインで自動テストを通過したマイグレーションスクリプト経由のみに制限。 【運用】 更新前の自動スナップショット取得を作業プロセスに組み込み。 |
| 設定ファイルの構文ミス | チェックリストを作成し、2名体制で指差し確認を徹底する。 | 【技術】 linterおよび構文チェッカーを導入し、不正値がある場合はデプロイが自動停止するガードレールを構築。 【組織】 パラメータ設計書のレビュー観点に型チェック項目を追加。 |
| 監視アラートの見落とし | 監視画面の巡回頻度を上げ、見落としがないよう周知徹底する。 | 【技術】 不要な警告アラートを削減(静観設定の適正化)し、重大アラートはSlack特定チャンネルへメンション付き即時通知。 【運用】 未対応アラートが15分継続した場合の自動エスカレーション通知を設定。 |
| 検証環境との差異による不具合 | 環境ごとの違いを意識して、慎重に手順を作成する。 | 【技術】 インフラ構成をIaCでコード管理し、検証環境と本番環境のパラメーター差分を自動検知する仕組みを導入。 【組織】 リリース前チェック基準に「IaCコード差分ゼロの確認」を義務付け。 |
実務でそのまま使える標準Markdownテンプレートです。コピーして各項目を埋めるだけで、論理的な報告書が完成します。
# システム障害報告書

## 1. 障害概要
* **事象名**:[例: 本番DBコネクション枯渇によるAPIサービス停止]
* **発生日時**:YYYY年MM月DD日 HH:MM
* **復旧日時**:YYYY年MM月DD日 HH:MM(総停止時間:X時間Y分)
* **影響範囲**:
  * 対象システム:[対象サービス名/サブシステム名]
  * 業務・顧客影響:[例: APIエラー約1,200件発生、一般ユーザーの決済処理が一時中断]

## 2. 障害タイムライン
| 日時 | 対応内容・状況 |
| :--- | :--- |
| HH:MM | 監視システムより「DB Connection High」アラートを検知 |
| HH:MM | 一次切り分け開始。特定APIからのコネクション急増を確認 |
| HH:MM | 暫定対処:対象APIサーバの再起動およびコネクションプールの強制解放を実施 |
| HH:MM | メトリクス正常化を確認、サービス暫定復旧を宣言 |

## 3. 原因分析
* **直接原因(何が起きたか)**:
  * [例: バッチ処理のデプロイに伴い、コネクションのクローズ漏れが発生しリソースが枯渇した]
* **根本原因(なぜ起きたか/なぜ防げなかったか)**:
  * **技術的要因**:[例: コネクションリークを検知する静的解析ツールがCIに未導入だった]
  * **運用・検知要因**:[例: ステージング環境での負荷テスト時間が短く、リークが顕在化しなかった]
  * **組織・プロセス要因**:[例: リリース判定基準において、長時間稼働試験の項目が形骸化していた]

## 4. 再発防止策(恒久対策)
| レベル | 対策内容 | 担当者 | 完了予定日 | 完了基準(検収条件) |
| :--- | :--- | :--- | :--- | :--- |
| **レベル1:即時是正** | 当該バッチのコネクション処理修正・再デプロイ | [氏名] | YYYY/MM/DD | ステージングでの単体テスト通過 |
| **レベル2:技術対策** | 静的解析(Linter)によるリソース解放チェックの自動化 | [氏名] | YYYY/MM/DD | CIパイプラインへの組み込み完了 |
| **レベル3:プロセス是正** | リリース判定基準の改定(長時間負荷テストの義務化) | [氏名] | YYYY/MM/DD | 運用変更管理委員会の承認・周知 |
上長や顧客へ送信・提出する直前に、以下の7項目を必ずセルフチェックしてください。
障害報告書を書く時間は、エンジニアにとって精神的につらい作業です。トラブル対応で体力を削られた後ならなおさら、「早く終わらせたい」という気持ちが先に立つのは自然なことです。
しかし、雑に仕上げた報告書で差し戻しを食らい、何度も書き直す時間こそが最もチームのリソースとメンタルを奪います。
障害は、システムや運用プロセスに潜んでいた「見えない負債」が表面化したシグナルです。
ロジカルななぜなぜ分析で真因を突き止め、物理的なガードレールとプロセスの是正へ落とし込む。そのサイクルを回せるようになれば、障害報告書は単なる「お詫び状」ではなく、「システムと組織をより強固にアップデートした設計書」へと変わります。
次回報告書を書く際は、ぜひ今回のテンプレートとチェックリストを手元に置き、論理のラインを整えてみてください。承認者の反応が劇的に変わるはずです。
▼▼▼まずはここからチェック!