【障害対応】– tag –
-

差し戻しゼロの「障害報告書」の書き方|なぜなぜ分析と再発防止策の例文・テンプレ付き
「また差し戻しか……」 深夜や休日の緊急トラブルをなんとか鎮火させ、疲労困憊のなか書き上げた障害報告書。それを上長や顧客に提出した瞬間、こんな言葉で突っ返された経験はないでしょうか。 「注意不足で済ませるな」 「ダブルチェックの徹底って、今ま... -
【障害対応】インシデント報告の完全フロー|初動15分速報テンプレとエスカレーション基準
「本番環境でアラート発報、サービスが応答していません!」 監視ツールからの通知が鳴り響いた瞬間、現場には特有の緊張が走ります。ログの調査、プロセスの確認、切り戻し手順の検討……。やるべき作業が山積みになる中で、多くの現場で最も後手に回り、の... -
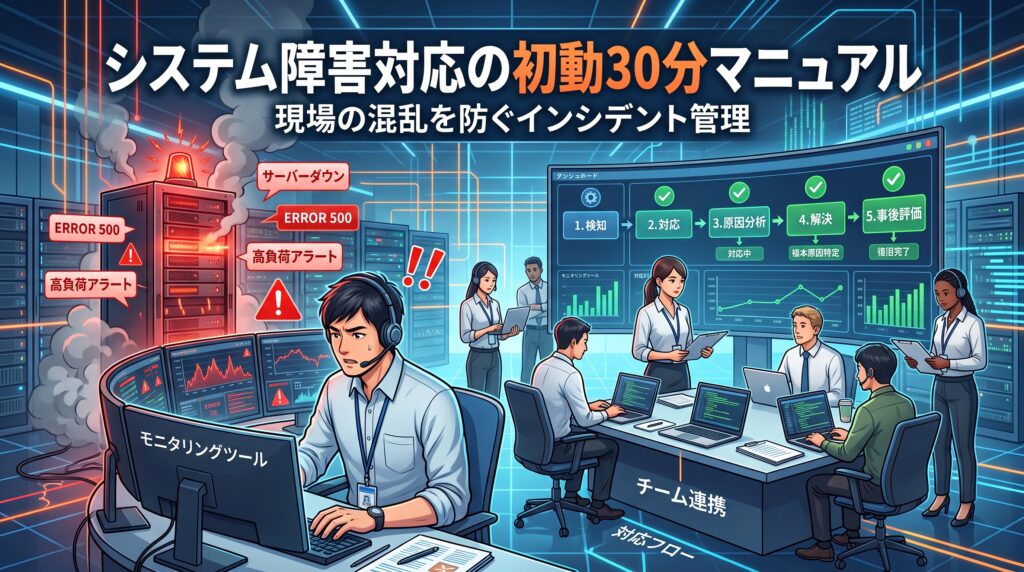
システム障害対応の初動30分マニュアル|現場の混乱を防ぐインシデント管理
深夜や休日のオンコール、あるいはアクセスが集中する日中のコアタイム。突然鳴り響くアラート通知とともに、ビジネスサイドやカスタマーサポートからチャットへ矢のような催促が飛んできます。 「〇〇サービスが落ちています!」 「管理画面にアクセスで... -
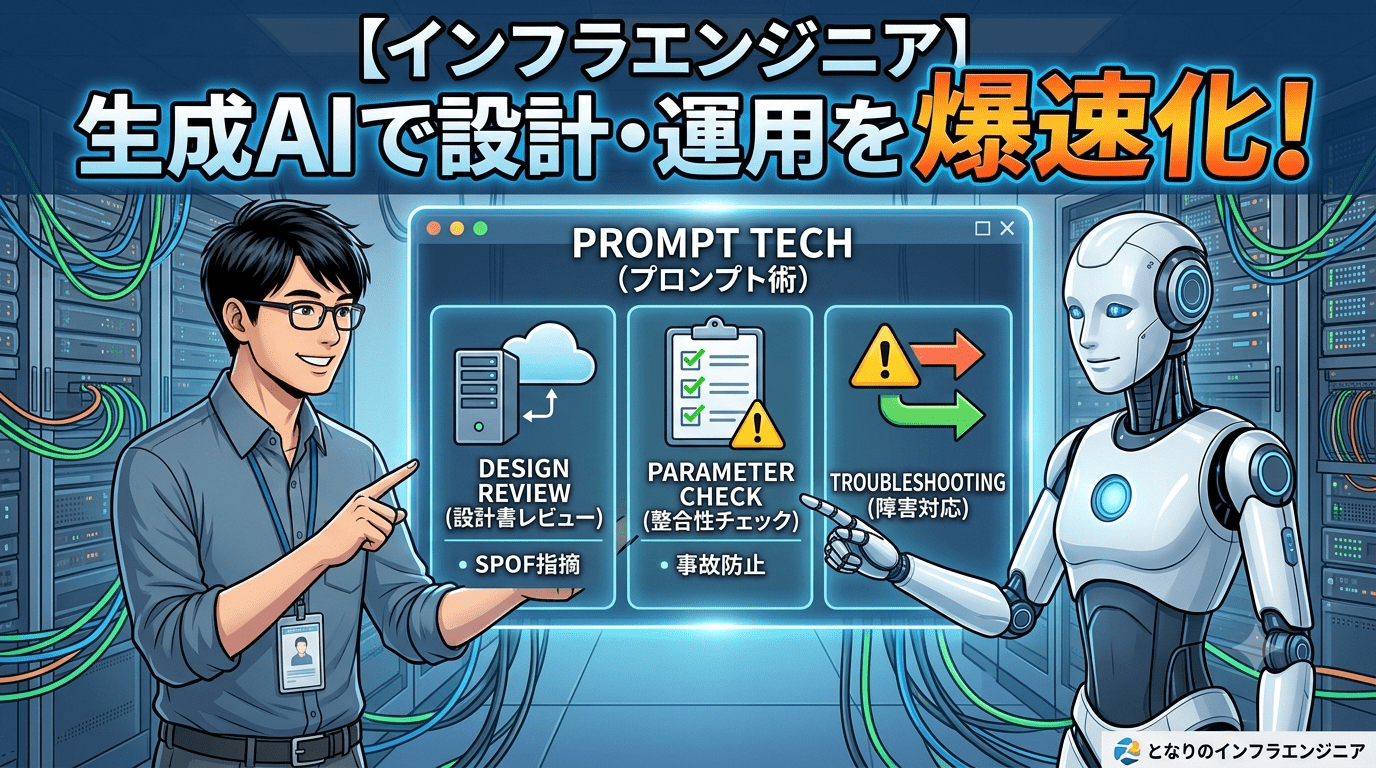
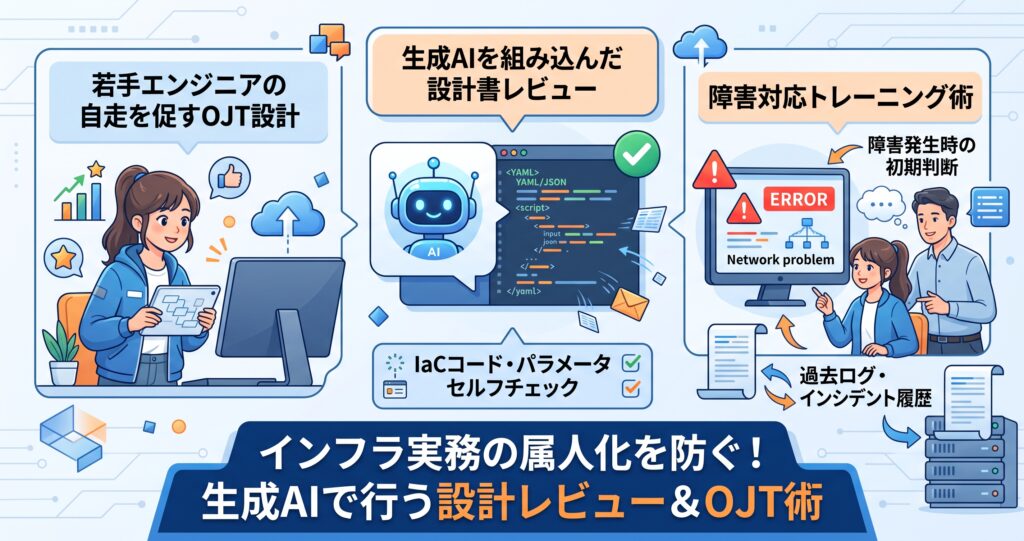
インフラ実務の属人化を防ぐ!生成AIで行う設計書レビュー&障害対応OJT術
現場の若手・中途メンバーの育成において、以下のような課題に直面していないでしょうか。 「手順書通りには動けるが、システム全体における位置づけを理解しておらず作業者目線から抜け出せない」 「過去に何度も指摘したパラメータの不整合やフォーマッ... -
【業務効率化】インフラエンジニアのAI活用術|障害切り分けと運用自動化の実践例
「深夜のアラート対応で起こされ、膨大なエラーログと格闘する……」「定型的なシェルスクリプトや環境構築コードの作成に何時間も取られる……」 日々の運用保守や構築作業で、このような泥臭い作業に追われていませんか? 最近では「ChatGPTなどの生成AIを使... -
【実録】300台のサーバが沈黙。システム障害対応の舞台裏でリーダーはどう動いたか
インフラエンジニアとしてキャリアを積む中で、避けては通れないのが「大規模システム障害」です。特に、物理レイヤの予期せぬ挙動は、時に冗長化構成という安全神話をいとも簡単に打ち砕きます。 今回は、私がかつて若手エンジニアとして経験した、「FCス... -
【障害・進捗報告】現役マネージャーが教えるインフラエンジニアの報告術と鉄則
障害対応や設定変更の報告で、リーダーや先輩から「で、結局どうなってるの?」と詰められた経験はありませんか? 「ちゃんと調べてから報告しようと思ったのに……」 「丁寧に応えようとしただけなのに……」 実は、その「丁寧さ」が、時として現場の足を引っ... -
Linuxログ調査の基本コマンド集(grep, awk, tail):巨大ログと戦う技術
「障害が発生した。至急ログを確認して原因を特定してくれ!」 そんな緊迫した場面で、あなたはどうやってログを調査していますか? 数GBを超えるような巨大なログファイルを前に、いつもの癖で vi や cat を実行しようとしているなら、少しだけ待ってくだ... -
障害対応で試されるリーダーシップ。技術力よりも「判断」と「責任」が重要な理由
「誰よりも技術に精通しているはずの自分が、なぜか現場を混乱させてしまう」 障害発生の報を受け、真っ先にコンソールを開き、ログを追い、ソースコードの迷宮に飛び込む。エンジニアとしてこれほど頼もしい姿はありません。しかし、ふと周りを見渡したと... -
アラートは成長の招待状。18年の現場で辿り着いた、インフラエンジニアの「障害対応学」
インフラエンジニアの仕事において、最も技術力と精神力が試されるのが「原因不明の障害」です。ログを見ても、監視データを見ても、明確な答えが見つからない。そんな「詰み」の状態をどう突破するか。 18年の現場経験から辿り着いた、論理的かつ戦略的な...


1